这是本节的多页打印视图。
点击此处打印 .
返回本页常规视图 .
组成原理 计算机组成原理在 408 试卷中占据 45 分,和数据结构一样,是分数占比最大的科目,同样会考察 11 道选择题和两道大题。
大题的考察重点在与指令系统、CPU 以及存储系统。指令系统和 CPU 常常会放在一起考察,作为一道大题。存储系统系统常常会和操作系统中的相关知识在一起考察,在复习时可以将这两门课的相关内容放在一起复习。
计算机组成原理的考察目标包含如下内容(来自 408 考研大纲):
掌握单处理器计算机系统中主要部件的工作原理、组成结构以及相互连接方式。 掌握指令集体系结构的基本知识和基本实现方法,对计算机硬件相关问题进行分析,并能够对相关部件进行设计。 理解计算机系统的整机概念,能够综合运用计算机组成的基本原理和基本方法,对高级编程语言(C 语言)程序中的相关问题进行分析,具备软硬件协同分析和设计能力。 1 - 概述 计算机组成原理的基本概念,可能会在选择题中考察,看到题目能够选出答案即可。
# 计算机系统概述
## 计算机系统层次结构
- 计算机系统的基本组成
- 计算机硬件的基本结构
- 计算机软件和硬件的关系
- 计算机系统的工作原理
## 计算机性能指标
1.1 - 计算机系统层次结构 选择题中频考点,需要熟悉下 冯诺依曼结构 和 计算机几个层次的语言 。
计算机体系结构 硬件 系统和 软件 系统共同构成了一个完整的计算机系统。硬件指的是有形的物理设备,是计算机系统中实际物理装置的总称。软件指的是在硬件上运行的程序和相关的数据及文档。
硬件 和 软件 关系:硬件是计算机的物理部分,它提供了运行软件所需的基础设施,而软件则是 指令集 ,指导 硬件如何工作以执行特定的任务。
计算机硬件 冯诺依曼结构 冯·诺依曼提出的 “存储程序” 的思想奠定了当代计算机的基本结构,以此概念为基础的各类计算机通称为 冯·诺依曼机 ,其特点如下:
计算机 硬件 系统由 运算器 、存储器 、控制器 、输入设备 和 输出设备 5 大部件 指令和数据 以同等地位存储在 存储器 中,形式上没有区别,但计算机应能区分它们。指令和数据均用 二进制代码 表示,指令包含操作码和地址码,操作码指出操作的类型,地址码指出操作数的地址。 以 运算器 为中心,其他部件配合其工作。 其中 五大部件
运算器 (ALU):负责算术运算(加减乘除)和逻辑运算(与或非)。控制器 (CU):从 存储器 中读取指令,解码并控制其他部件协同工作。存储器 (Memory):存储程序指令和运算数据(如内存、硬盘)。输入设备 (Input):接收外部数据(如键盘、鼠标)。输出设备 (Output):将结果反馈给用户(如显示器、打印机)。计算机软件 系统软件和应用软件 系统软件 (System Software)定义:系统软件 是直接运行在 硬件 上的 软件 ,为其他 软件 提供一个运行和执行的平台。 功能:管理和控制计算机 硬件 ,使其能够与 应用软件 进行交互。 提供 应用软件 开发的基础服务和接口。 应用软件 (Application Software)定义:应用软件 是构建在 系统软件 之上,为用户提供特定功能或执行特定任务的 软件 。 功能:解决用户的具体问题或满足特定需求。 提供与用户的直接交互界面。 三个级别的语言 机器语言 (Machine Language):定义:这是 计算机硬件 直接理解和执行的语言,它是用 二进制代码 表示的(通常是 0 和 1)。 特点:与特定计算机架构紧密相关。 非常低级:每条机器代码对应 硬件 的一个操作。 对于人类来说,阅读和编写是困难的。 汇编语言 (Assembly Language):定义:这是一种低级编程语言,它使用符号和助记符(而非 二进制代码 )来代表机器语言的指令。 特点:与特定计算机架构紧密相关。 比机器语言更容易理解和编写。 需要一个汇编器来将汇编代码转换为机器代码。 高级语言 (High-Level Language):定义:这是为了更方便地编写和理解计算机程序而设计的语言。它们与特定的 硬件平台 相对独立。 特点:抽象度高,语法通常更接近自然语言或数学符号。 可以在不同的 硬件平台 上运行,只需适当地 编译 或 解释 。 需要一个 编译器 或 解释器 来将高级语言代码转换为机器代码(或执行)。 三种语言的关系可以参照下图理解:
ProgrammingLanguageLevels cluster_high 高级语言 (High-Level Language) cluster_assembly 汇编语言 (Assembly Language) cluster_machine 机器语言 (Machine Language) HighLevel 高级语言 • Python, Java, C++ • 接近自然语言 • 硬件独立 • 抽象度高 Compiler 编译器 (Compiler) HighLevel->Compiler 编译 Interpreter 解释器 (Interpreter) HighLevel->Interpreter 解释 Examples 💻 代码示例: ━━━━━━━━━━━━━ print('Hello World') for i in range(10): print(i) ━━━━━━━━━━━━━ Examples->HighLevel Assembly 汇编语言 • 符号和助记符 • 架构相关 • 比机器语言易读 Assembler 汇编器 (Assembler) Assembly->Assembler 汇编 AsmExamples 💾 代码示例: ━━━━━━━━━━━━━ MOV AX, 5 ADD AX, 3 INT 21h ━━━━━━━━━━━━━ AsmExamples->Assembly Machine 机器语言 • 二进制代码 (0,1) • CPU直接执行 • 硬件相关 Hardware 计算机硬件 CPU, 内存, 存储 Machine->Hardware 直接执行 BinaryExamples ⚙️ 代码示例: ━━━━━━━━━━━━━━━━━━ 10110000 01100001 01001000 11000111 ━━━━━━━━━━━━━━━━━━ BinaryExamples->Machine Compiler->Machine 生成 Interpreter->Machine 逐行转换 Assembler->Machine 转换 Abstract 抽象程度 Abstract->HighLevel 高 Abstract->Assembly 中 Abstract->Machine 低 计算机系统的工作原理 从源程序到可执行程序 预处理 (Preprocessing):预处理器 会执行宏替换、文件包含、条件编译等任务,仅限于某些语言,比如 C 和 C++。预处理后得到预处理后的源程序。编译 (Compilation):编译器 将预处理后的源程序转换为 汇编语言代码 。汇编 (Assembly):汇编器 将汇编语言代码转换为 目标文件 ,其中包含机器代码以及重定位、符号等信息。链接 (Linking):链接器 将一个或多个目标文件与所需的库文件链接在一起,生成一个可执行文件,并完成符号解析和地址重定位等工作。加载和执行 (Loading & Execution):当你运行可执行文件时,操作系统的 加载器 会将程序装入内存,并完成必要的运行时准备。随后 CPU 从程序入口开始取指、译码并执行指令。整个工具链流程如下图所示,每一阶段由对应的工具产出下一阶段的输入文件:
hello.c 源代码 hello.i 预处理代码 hello.s 汇编代码 hello.o 目标文件 hello (a.out) 可执行文件 预处理器 编译器 汇编器 链接器 + 库 gcc -E gcc -S gcc -c gcc / ld 加载器 → CPU 执行 # 预处理:.c → .i
gcc -E hello.c -o hello.i
# 编译:.c/.i → .s
gcc -S hello.c -o hello.s
# 汇编:.s → .o
gcc -c hello.s -o hello.o
# 链接:.o → 可执行文件
gcc hello.o -o hello
# 加载并执行
./hello
需要注意的是,gcc 本身是一个 编译驱动程序 ,会自动调用预处理器、编译器、汇编器和链接器。因此,直接执行:
gcc -c hello.c -o hello.o
实际上会自动完成:
hello.c → 预处理 → 编译 → 汇编 → hello.o
1.2 - 计算机性能指标 在选择题中会直接考查,也会在解答题间接考查,每个计算机性能指标都要深入掌握。
CPU 指标 时钟周期 时钟周期 (Clock Cycle)是计算机中 CPU 执行指令的基本时间单位,由系统时钟产生的一个“高低电平”变化(通常称为 脉冲 )所定义。
计算机内部有一个 晶体振荡器 ,通常采用石英晶体,利用其压电效应产生规律的 脉冲信号
原始的脉冲信号 是一个连续的 模拟信号 ,在计算机系统中,这个模拟信号通常不会直接使用。为了适配数字电路的需要,晶体振荡器 产生的 模拟信号 会经过整形和分频电路处理,转换为方波形式的 数字脉冲信号 ,用于同步计算机中各个硬件组件的操作。时钟脉冲信号 的宽度,即连续两个 脉冲 之间的时间间隔,称为 时钟周期 。
计算机中所有的设备都使用相同的时钟周期么?
不一定 。某些组件(如 CPU 和 内存 等)需要同步工作,但不同的设备可能使用不同的时钟周期。
因此计算机内部的设备之间的同步方式可以分为 同步 和 异步 两种。同步设备 使用相同的时钟信号,而 异步设备 则使用不同的时钟信号或不使用时钟信号。
主频 主频 (CPU Frequency),是指中央处理器(CPU )的 时钟频率
CPU 每秒可以执行多少个基本 时钟周期 。时钟周期 和 主频 互为倒数 :
Frequency = Clock Cycle 1
其单位通常是 MHz (兆赫)或 GHz (千兆赫)。它决定了 时钟振荡 的快慢:
1 Hz :每秒
1 时钟振荡 1 MHz =
1 0 6 1 GHz =
1 0 9 比如,一个 3.0 GHz 的 CPU ,主频是 3,000,000,000 Hz ,意味着它每秒经历 30 亿 个 时钟周期 。
指令执行指标 CPI CPI (Cycle Per Instruction):也称 指令周期 ,即一条指令所需要的平均 时钟周期 。
下图展示了 指令周期 、机器周期 和 时钟周期 三者的关联:
三者具有层级关系:时钟周期 < 机器周期 < 指令周期 。
时钟周期 是硬件层面的最小时间单位。机器周期 是由多个 时钟周期 组成,用于完成一个基本操作(如取指令、存储数据)。指令周期 是由多个 机器周期 组成,用于完成一条指令的执行。IPC IPC (Instruction Per Cycle):也称 每周期指令 ,即每个 时钟周期 执行的平均指令数,是 CPI 的 倒数 。
IPC = CPI 1
IPS IPS (Instruction Per Second):也称 每秒指令数 ,即每秒平均能够执行多少条指令。
IPS = CPI 主频
MIPS MIPS (Million Instructions Per Second):也称 每秒百万指令数 ,即每秒能够执行 多少个 百万的指令。
1 MIPS = 1 0 6 IPS
浮点运算指标 FLOPS FLOPS (Floating-point Operations Per Second,每秒浮点运算次数)是衡量计算机浮点运算性能的指标,它表示处理器每秒能执行的浮点运算次数,通常用来评估 GPU 或 AI 芯片 的性能。
MFLOPS (Million FLOPS): 百万(
1 0 6 GFLOPS (Giga FLOPS): 十亿次(
1 0 9 TFLOPS (Tera FLOPS): 万亿次(
1 0 12 PFLOPS (Peta FLOPS): 千万亿次(
1 0 15 EFLOPS (Exa FLOPS): 百亿亿次(
1 0 18 ZFLOPS (Zetta FLOPS): 万亿亿次(
1 0 21 每次指标提升都是
× 1 0 3 GFLOPS = 1 0 3 MFLOPS
FLOPS_units MFLOPS MFLOPS Million = 10^6 GFLOPS GFLOPS Giga = 10^9 MFLOPS->GFLOPS ×10³ TFLOPS TFLOPS Tera = 10^12 GFLOPS->TFLOPS ×10³ PFLOPS PFLOPS Peta = 10^15 TFLOPS->PFLOPS ×10³ EFLOPS EFLOPS Exa = 10^18 PFLOPS->EFLOPS ×10³ ZFLOPS ZFLOPS Zetta = 10^21 EFLOPS->ZFLOPS ×10³ legend 注: 1 FLOP = 1 次浮点运算 每级相差 10^3(千倍) 计算机指标 字长 字长 (Word Length)指的是计算机在内部一次操作中所能处理的 二进制数字位数 。例如,一个 32 位 的 CPU 一次可以处理 32 位 的数据。
数据通路带宽
数据通路带宽 (Data Bus Width) 是 CPU 和 内存 之间传输数据的宽度,通常以 位 为单位表示。比如,64 位 的数据总线意味着每个 时钟周期 内,可以传输 64 位 的数据。
主存容量 主存储器 能够存储信息的最大容量,通常用 字节 来衡量。
MAR 的 位数 反映了 可寻址范围 的最大值(不一定是存储器的实际容量),与 地址总线 的 位数 一致。
这里主要看清题目中的 按字节寻址 和 按字寻址 ,内存空间 / 寻址单位 = 可寻址范围,通过 可寻址范围 计算 MAR 的 位数 。
比如主存地址空间大小为 128KB=
2 17
吞吐量 吞吐量 (Throughput)表示在 单位时间 内,系统可以完成的 任务数量 。在计算机网络中,它可能表示 数据的传输速率 ;在 计算 中,它可能表示 每秒执行的操作数 。
2 - 数据表示和计算 本章在选择题中考察,需要熟练掌握补码表示以及浮点数的 IEEE 标准。
# 数据的表示和运算
## 数制和编码
- 进位计数制及其数据之间的相互转换
- 定点数的编码表示
## 运算方法和运算电路
- 基本运算部件
- 加/减运算
- 乘/除运算
## 整数的表示和运算
- 无符号整数
- 带符号整数
## 浮点数的表示和运算
- IEEE 754标准
- 浮点数的加/减运算
2.1 - 整数的表示 本章是每年必考的重点,补码 、有符号数 和 无符号数 每年都会在选择题考查,也会在大题直接或间接考查,并且本章是组成原理的基础,必须 完全掌握 。
BCD 码 BCD (Binary-Coded Decimal)码是一种 二进制编码方法 ,用于表示 十进制数字 。每个十进制数字(0-9)都使用 四位二进制数字 表示。
BCD 码的基本思路是 单独表示每个十进制数字的二进制值 ,而不是像传统的二进制数系统那样对整个数字进行编码。例如,在传统的二进制编码中,数字"19"会表示为 10011,但在 BCD 中,它被表示为两个独立的数字:“0001”(对应于 1)和“1001”(对应于 9),因此整个表示为“0001 1001”。
0 - 0000 1 - 0001 2 - 0010
3 - 0011 4 - 0100 5 - 0101
6 - 0110 7 - 0111 8 - 1000
9 - 1001
BCD 编码在某些应用中是很有用的,特别是在需要与 十进制界面 进行交互的地方,如 数字显示 或某些早期的计算机系统。尽管它不如 纯二进制编码 效率高,但它简化了与十进制数据的转换过程。
整数的表示 在介绍整数的不同表示之前,我们首先要定义清楚不同的名词,否则会造成极大的概念混淆。
在日常生活中,我们使用十进制表示数字,并通过符号(如 + 和 -)表示正负。这种用十进制表达的数字也叫做 字面值 。
而计算机以二进制形式存储数据,补码、原码、无符号数 等只是 对二进制位的一种解释方式 ,它们决定了同一组二进制位所代表的实际数值。
在实际的计算机中,没有采用 原码 存储数据的,具体原因后面会谈到到。对于计算机中存储的数字来说,它的二进制只可能是 有符号数 (signed) 或者 无符号数 (unsigned) 这两种情况。
无符号数 无符号数 (unsigned number) 是计算机中一种整数类型,只能表示 非负数 (包括 0 和正整数),不包含负数。
纯二进制表示 在非负数中,数字中的第
n 2 n
对于一个
n 无符号数
U i b i U binary = b n − 1 ⋯ b 1 b 0
U decimal = i = 0 ∑ n − 1 2 i ⋅ b i
纯二进制表示范围
根据以上公式可知,一个
n
最小值 :
0 最大值 :
2 n − 1 表示范围 :
[ 0 , 2 n − 1 ] 需要注意的是,无符号数 就是没有符号的二进制表示,它不像 有符号数 的表示,有一个 补码 这个专有名词。但是我们一般可以叫它 纯二进制 或 无符号数二进制表示 。
二进制 → 十进制 这里为了方便说明如何将 unsigned 转化为 十进制字面值 ,采用 8 位 无符号数 进行说明,其中每一位表示的实际大小如下表所示:
第 7 位 第 6 位 第 5 位 第 4 位 第 3 位 第 2 位 第 1 位 第 0 位 2 7 = 128 2 6 = 64 2 5 = 32 2 4 = 16 2 3 = 8 2 2 = 4 2 1 = 2 2 0 = 1
2 0 = 1 2 1 = 2 2 2 = 4 2 6 = 64 2 7 = 128 10000001 对应的值为
128 + 1 = 129 10001001 对应的值为
128 + 8 + 1 = 137 01000001 对应的值为
64 + 1 = 65 在现代 64 位计算机中,unsigned 是 32 位非负数。也可以使用 uint16_t 表示 16 位非负数、uint32_t 表示 32 位非负数、uint64_t 表示 64 位非负数。
十进制 → 二进制 将 十进制字面值 转化为 无符号数 的方法就是使用
U decimal = ∑ i = 0 n − 1 2 i ⋅ b i
如果数字不太复杂,可以利用直觉直接观察,将一个数字转化为若干个 2 的 n 次方之和(1, 2, 4, 8 …)。比如
73 = 64 + 8 + 1 = 2 6 + 2 3 + 2 0
第二种方法稍微麻烦点,就是充当人脑计算机,采用 除 2 取余法
73 ÷ 2 = 36 ... 1
36 ÷ 2 = 18 ... 0
18 ÷ 2 = 9 ... 0
9 ÷ 2 = 4 ... 1
4 ÷ 2 = 2 ... 0
2 ÷ 2 = 1 ... 0
1 ÷ 2 = 0 ... 1
接下来将余数进行逆序重排得到二进制数:1001001,因为是 8 位数,所以在剩下的高位全部填上 0,得到结果 01001001 。
总结两种转换方式如下图:
十进制转二进制两种方法 方法一:直观分解法 示例:73 转换为二进制 73 = 64 + 8 + 1 73 = 2⁶ + 2³ + 2⁰ 位置: 7 6 5 4 3 2 1 0 2的幂: 2⁷ 2⁶ 2⁵ 2⁴ 2³ 2² 2¹ 2⁰ 数值: 128 64 32 16 8 4 2 1 二进制: 0 1 0 0 1 0 0 1 64 8 1 方法二:除2取余法 计算过程: 除法运算 商 余数 73 ÷ 2 = 36 1 36 ÷ 2 = 18 0 18 ÷ 2 = 9 0 9 ÷ 2 = 4 1 4 ÷ 2 = 2 0 2 ÷ 2 = 1 0 1 ÷ 2 = 0 1 余数逆序排列: 1 0 0 1 0 0 1 逆序排列 8位二进制结果: 01001001 两种方法得到相同结果 73₁₀ = 01001001₂ (8位无符号二进制) 有符号数 在程序中使用 short、int、long 定义的整形变量就是 有符号数 (signed),有符号数使用 补码(Two’s complement) 进行表示。
补码表示 有符号数 使用的 补码 与 无符号数 使用的 纯二进制 表示方式基本相同,除了最高位。对于一个
n − 2 n − 1 2 n − 1
对于一个
n 有符号数
S i b i S binary = b n − 1 ⋯ b 1 b 0
S decimal = i = 0 ∑ n − 2 2 i ⋅ b i − 2 n − 1 ⋅ b n − 1
补码的表示范围
根据以上公式可知,一个
n 补码 的:
最小值(最负数) :
− 2 n − 1 最大值(最正数) :
2 n − 1 − 1 表示范围 :
[ − 2 n − 1 , 2 n − 1 − 1 ] 补码的命名
那么 补码 的命名为什么叫 Two’s Complement 呢?
对于表示范围内的正数,补码 和 纯二进制表示 的二进制表示是相同的;但是对于负数,两者的二进制表示不同,这也是它名称的来源。
Two’s Complement 中的 Two 强调二进制系统;比如十进制中有 10’s complement(十的补码),那么在二进制中自然就是 2’s complement 。
Complement 指 补数
它的补数 等于某个基数的幂。比如对于数字
x n
x 的二进制补数 = 2 n − x
所以如果给定了一个 十进制字面值 ,我们可以先计算其 纯二进制表示 ,再进行二进制减法,将
2 n 补码表示 。
比如假设给定一个十进制
D 除 2 取余法 计算其 纯二进制表示
U bina ry = u n − 1 ⋯ u 1 u 0 2 n
以上二进制减法等同于对
U 取反加一
D 补码
S
S = 2 n − U = U ˉ + 1
二进制 → 十进制 这里为了方便说明,以 8 位 补码 为例说一下如何将 补码表示的二进制 转化为实际十进制数字。
首先,8 位补码中的每一位的大小为:
第 7 位 第 6 位 第 5 位 第 4 位 第 3 位 第 2 位 第 1 位 第 0 位 − 2 7 = − 128 2 6 = 64 2 5 = 32 2 4 = 16 2 3 = 8 2 2 = 4 2 1 = 2 2 0 = 1
2 0 = 1 2 1 = 2 2 2 = 4 2 6 = 64 -2 7 = -128 例子:
10000001 对应的值为
− 128 + 1 = − 127 10001001 对应的值为
− 128 + 8 + 1 = − 119 01000001 对应的值为
64 + 1 = 65 以 8 位二进制数为例:
对于正数,例如 +5,其二进制表示为 00000101,补码 也是 00000101。 对于负数,例如 -5,首先写出 5 的二进制表示:00000101。按位取反得到:11111010 加 1 得到:11111011 所以,-5 的 补码 是 11111011。 十进制 → 二进制 这里仅讨论如何将一个 十进制负数 转化为 补码二进制 ,因为对于非负数,补码 的二进制表示和 纯二进制 相同。
一种比较简单的转换方法就是基于
S decimal = ∑ i = 0 n − 2 2 i ⋅ b i − 2 n − 1 ⋅ b n − 1
比如
− 73 = − 128 + 55 = − 128 + 32 + 16 + 4 + 2 + 1 = − 2 7 + 2 5 + 2 4 + 2 2 + 2 1 + 2 0 补码 为 1011 0111 。
另一种就是先计算该数字绝对值的 纯二进制表示 ,再将其通过 取反加一
补码 。
比如通过第二种方式将 -73 转为 补码 :
-73 是负数,其绝对值为 73。 通过 除 2 取余法 得到其 无符号表示 为 0100 1001。 取反:1011 0110。 加一:1011 0111。 结果为 1011 0111 。
十进制负数 → 补码二进制转换 十进制: -73 方法一:基于公式直接观察 S = Σ(i=0 to n-2) 2^i × bi - 2^(n-1) × bn-1 -73 = -128 + 55 = -128 + 32 + 16 + 4 + 2 + 1 = -2^7 + 2^5 + 2^4 + 2^2 + 2^1 + 2^0 位置: 7 6 5 4 3 2 1 0 补码: 1 0 1 1 0 1 1 1 方法二:取反加一法 步骤1: |-73| = 73 的纯二进制 73 = 64 + 8 + 1 = 2^6 + 2^3 + 2^0 01001001 步骤2: 取反 (0↔1) 10110110 步骤3: 加1 10110110 + 1 = 10110111 两种方法得到相同结果 方法一结果: 10110111 方法二结果: 10110111 验证: 10110111(补码) → 十进制 = 1×2^0 + 1×2^1 + 1×2^2 + 0×2^3 + 1×2^4 + 1×2^5 + 0×2^6 - 1×2^7 = 1 + 2 + 4 + 0 + 16 + 32 + 0 - 128 = 55 - 128 = -73 ✓ 注: 最高位为符号位,1表示负数,0表示非负数 优点 使用 补码 可以使得 加法、减法和负数的表示 变得简单和统一。比如给定两个数字 A 和 B,我们想要计算 C = A + B。A + B 由硬件加法器得到的二进制结果可以直接作为 C 的二进制表示。
补码 的设计使得负数的加法变得简单。当使用 补码 表示时,可以直接将两个数相加,即使其中一个数是负数,而不需要进行任何特殊处理。这简化了计算机硬件的设计。
原码 原码(Sign-Magnitude) 是一种简单的方式来表示二进制中的 有符号整数 。在这种表示法中,数字的 最高位 (最左边的位)用于表示符号,其余的位表示数字的大小。通常,符号位为 0 表示正数,而 1 表示负数。
表示方法 原码的表示方法:
正数的原码:最高位 为 0,其余位表示这个数的绝对值的二进制形式。 负数的原码:最高位 为 1,其余位表示这个数的绝对值的二进制形式。 零的原码:符号位可以是 0(表示 +0)或 1(表示 -0),但在实际应用中,通常只使用一个零,即符号位为 0。 原码(Sign-Magnitude)表示法 8位原码结构: 7 6 5 4 3 2 1 0 S 数值位(Magnitude Bits) 符号位 绝对值的二进制表示 符号位规则: 0 = 正数 1 = 负数 示例: 正数:+25 25的二进制:11001 0 0 0 1 1 0 0 1 00011001 = +25 负数:-25 25的二进制:11001(绝对值相同) 1 0 0 1 1 0 0 1 10011001 = -25 零的表示: +0: 0 0000000 -0: 1 0000000 (实际应用中通常只使用+0) 原码特点: • 符号位独立于数值位 • 正负数的数值位相同 • 直观易懂 • 运算复杂(需要判断符号) • 存在+0和-0两个零 举例(以 8 位二进制数为例):
+25 的原码是:0 0011001 -25 的原码是:1 0011001 缺点 存在 正零 和 负零 的表示。 在进行算术运算时,正数和负数需要不同的处理,这使得硬件设计变得复杂。 由于上述的缺点,原码 并不是计算机中最常用的表示法。在现代计算机中,补码 是更常用的方式来表示 有符号整数 ,因为它简化了算术运算的处理,并且没有 +0 和 -0 的冗余表示。
2.2 - 浮点数表示 IEEE 浮点数表示的方法非常重要,每年选择题都必考,需要能够熟练计算 IEEE 浮点数的二进制和十进制之间的关联。
实数的二进制表示 实数在计算机中的存储遵循 IEEE 浮点数标准 ,但在这里为了方便理解 IEEE 标准,这里首先阐明一般 实数 在计算机中是如何存储的。
在这里 实数 分为两个部分存储:整数部分 和 小数部分 ,两个部分在逻辑上用 · 隔开。
比如对于以下 浮点数 的二进制表示:
d m d m − 1 ⋯ d 1 d 0 ⋅ d − 1 d − 2 ⋯ d − n
其中每一位对应的数值如下表所示:
d m d m − 1 ⋯ d 1 d 0 d − 1 d − 2 ⋯ d − n 2 m 2 m − 1 ⋯ 2 1 1/2 1/4 ⋯ 1/ 2 n
上述二进制表示对应的数值为
b = i = − n ∑ m 2 i × b i
其中
b i = 0 b i = 1 i 为是 0 还是 1。
举例说明如何使用上述表示法计算 实数 :
101.1 1 2 1 × 2 2 + 0 × 2 1 + 1 × 2 0 + 1 × 2 − 1 + 1 × 2 − 2 = 5.75 1011. 1 2 8 + 0 + 2 + 1 + 2 1 = 11.5 字面值转二进制 举个实际的例子,将 1.2 转换为二进制表示。
整数部分 1 的二进制是 1。小数部分 0.2 的二进制表示是一个无限循环小数。通过不断乘以 2,可以得到近似的二进制:
0.2 × 2 = 0.4 → 整数部分 0 0.4 × 2 = 0.8 → 整数部分 0 0.8 × 2 = 1.6 → 整数部分 1 0.6 × 2 = 1.2 → 整数部分 1 0.2 × 2 = 0.4 → 重复… 于是,1.2 在二进制中近似为 1.0011001100110011...。
IEEE 浮点数表示 上述 浮点数 存储方式的缺点在于如果要表示比较大的数,就需要比较多的二进制位数,比如对于
5 × 2 100 IEEE 表示 就解决了这个问题,在 IEEE 表示 中,浮点数
V V = ( − 1 ) s × M × 2 E s , M , E
IEEE 754 标准 是定义浮点数表示和算术的国际标准,它定义了多种不同精度的浮点数格式,但最常见的是 单精度 single precesion (32 位)和 双精度 double precesion (64 位),浮点数分为 s(符号位 )、exp(阶码 )、frac(尾数 )三个部分存储:
1 s 符号位
s 最高位 ,标志了浮点数的正负,如果
s = 1 V s = 0 V
k e x p = e k − 1 ⋯ e 1 e 0 指数部分
E e x p E = e x p − B ia s B ia s = 2 k − 1 − 1
对于 单精度 浮点数k = 8 B ia s = 2 8 − 1 − 1 = 127 1 ≤ e x p ≤ 254 − 126 ≤ E ≤ 127 对于 双精度 浮点数k = 11 B ia s = 2 11 − 1 − 1 = 1023 1 ≤ e x p ≤ 2046 − 1022 ≤ E ≤ 1023 n f r a c = 0 ⋅ f n − 1 ⋯ f 1 f 0 因子
M M = 1 + f r a c f r a c 实数的二进制表示
对于 单精度 浮点数,
n = 23 M 2 − 2 − 23 M 1 对于 双精度 浮点数,
n = 52 M 2 − 2 − 52 M 1 总结 单精度 和 双精度 浮点数 表示如下:
类型 符号位 s 阶码 exp 尾数 frac 总位数 偏置值 单精度 1 8 23 32 127 双精度 1 11 52 64 1023
单精度 浮点数表示为:
( − 1 ) s × 1. frac × 2 exp − 127
双精度 浮点数表示为:
( − 1 ) s × 1. frac × 2 exp − 1023
总结 单精度 和 双精度 浮点数中各个字段的范围如下图所示:
IEEE 754 浮点数存储格式 V = (-1)^s × M × 2^E 单精度 (32位) s 31 exp (8位) 30 23 frac (23位) 22 0 单精度参数: • k = 8, Bias = 127 • 1 ≤ exp ≤ 254 • -126 ≤ E ≤ 127 • n = 23, 1 ≤ M ≤ 2-2^(-23) 双精度 (64位) s 63 exp (11位) 62 52 frac (52位) 51 0 双精度参数: • k = 11, Bias = 1023 • 1 ≤ exp ≤ 2046 • -1022 ≤ E ≤ 1023 • n = 52, 1 ≤ M ≤ 2-2^(-52) 计算公式: • 符号位:s = 0 (正数), s = 1 (负数) • 指数部分:E = exp - Bias • 尾数部分:M = 1 + frac (隐含的前导1) 优势:相比传统浮点表示,IEEE 754格式可以用更少的位数表示更大的数值范围 例如:5×2^100 在IEEE格式中只需要标准的32位或64位,而不需要103位 图例 符号位 阶码 (单精度) 阶码 (双精度) 尾数 (单精度) 尾数 (双精度)
异常值 注意 IEEE 浮点数 表示分为 Normalized Values (正常值)和 Denormalized Values (非正常值)以及特殊值 ,上节中提到的 IEEE 浮点数 计算方法只适用于 正常值 ,正常值 的 阶码 (exp)不能为全 0 或全 1。
下图是 浮点数 各种类型的图示(以 单精度 为例):
非正常值 (Denormalized)的 阶码 全为 0无穷大 (Infinity)的 阶码 全为 1,尾数 位为 0非数字 (NaN,Not a Number)的 阶码 全为 1,尾数 位不为 0需要注意的是 非正常值 的 浮点数 计算公式 与 正常值 不同:
value = ( − 1 ) sign × 0. f × 2 1 − bias
注意这里的:
没有隐含的 “1”,因为它是 非正规数 。 指数固定为
1 − bias e − bias 阶码 是全 0) 这是为了在非常接近 0 的地方保持精度连续性 (即从最小正规数向 0 过渡的“填充区”) 下表总结了给出了 浮点数 表示各种情况的有效值计算:
类型 阶码(exp) 尾数(fraction) 有效值公式 正常值 非全 0、非全 1 f ± 1. f × 2 e − bias 非正常值 全 0 f 0 ± 0. f × 2 1 − bias ± 0 全 0 全 0 ± 0 ± ∞ 全 1 全 0 ± ∞ NaN 全 1 非 0 Not a Number(结果非法或未定义)
字面值转二进制 前文已经提到如果我们有 浮点数 的 IEEE 二进制表示 ,如何将其转化为实际的 浮点数 ,就是通过如下的公式:
( − 1 ) s × 1. frac × 2 exp − bias
还有一种常见的考题是给定我们一个 浮点数字面值 ,比如 2.25 ,然后让我们去反推它的二进制表示,这里有没有什么简便的解法呢?
最简便的方法还是反向转换 ,即将一个 浮点数 表示为 一点几几 (
1. frac 2 n 阶码 和尾数 ,然后符号位 由数字的正负判断。
以 2.25 为例,如果我们想得到该 浮点数 的 单精度 表示:
2.25 = 1.125 × 2 1 = 8 9 × 2 1 = ( 1 + 8 1 ) × 2 1 = ( 1 + 2 − 3 ) × 2 1
由此可以计算出 浮点数 的各个部分:
符号位 为 0阶码 为
1 + 127 = 128 1000 0000B尾数 为 0010 0000 0000 ....所以 浮点数 的二进制为 0100 0000 0001 0000 ...,十六进制为 40100000H
一般而言,试题只会考察这种没有精度损失的 浮点数二进制转换 ,对于有精度损失的情况,由于比较繁琐,基本不会考察,其 尾数 部分的计算与 一般实数字面值转二进制 相同。
表示精度 上述的例子是一个比较理想的例子,2.25 可以精确地用 浮点数 表示。但在真实场景中,很多 实数 都无法精确地用 浮点数 表示。比如 1.2 这个数:
1.2 = ( 1 + 5 1 ) × 2 1
其中
5 1 = 0.0011001100110011 ⋯ 2
是一个无限循环二进制小数 ,因此无法用有限位的 尾数 精确表示,只能选择一个最接近的值进行近似,这也是 浮点数精度误差 的来源。
若要理解这种近似过程,我们首先需要理解 精度 的概念。
为了便于说明,暂时忽略 规格化 ,假设仅使用 3 位二进制小数 来表示区间 [0, 1] 中的小数,则能够精确表示的数为:
i = 1 ∑ 3 f i 2 − i , f i ∈ { 0 , 1 }
即:
0 , 8 1 , 8 2 , 8 3 , 8 4 , 8 5 , 8 6 , 8 7
在数轴中对应 [0, 1] 区间上的 8 个离散点:
如果某个小数恰好不在这些离散点上,例如 0.3 ,则只能选择其中距离最近的一个点来近似表示,这就是 浮点数表示误差 的来源。
随着 尾数 位数不断增加,相邻两个可表示数之间的间隔会越来越小,因此能够更精确地逼近真实数值。
例如:
单精度浮点数 的 尾数 (frac)为 23 位 ,在固定指数下,相邻两个可表示数之间的间隔约为2 − 23
双精度浮点数 的 尾数 为 52 位 ,在固定指数下,相邻两个可表示数之间的间隔约为2 − 52
因此,尾数位数越多 ,相邻两个可表示浮点数之间的距离越小,也就意味着 精度越高 ,用来近似表示无法精确表示的实数时,误差也越小。
舍入(Rounding) 是将一个实数转换为指定浮点精度的过程。由于许多数学运算的结果无法用有限位的 浮点数 精确表示,因此需要将其舍入到距离最近的可表示浮点数。IEEE 754 默认采用**舍入到最近值(Round to Nearest, Ties to Even)**作为默认舍入方式。
浮点数加减 浮点数加减操作考察得不是很多,但如果掌握了浮点数表示的基本原理,理解其运算过程并不困难。需要特别注意:对阶、尾数运算、规格化、舍入 这几个步骤可能对 阶码和精度 产生不同影响。
浮点数 加减计算通常包含以下几个步骤:
对阶 尾数加减 规格化(右规或左规) 舍入 对阶 为了进行加减运算,两个 浮点数 必须具有相同的阶码,因此采用小阶向大阶对齐 的原则:
比较两个浮点数的 阶码 。 将阶码较小 的浮点数的 尾数右移 ,直到两个阶码相等。 阶码较大的浮点数保持不变。 例如:
1.10 1 2 × 2 3 + 1.1 1 2 × 2 1
将第二个数向第一个数对阶:
1.1 1 2 × 2 1 = 0.011 1 2 × 2 3
因此,对阶的本质是:
阶码较小的数,尾数右移,阶码增大;最终两个阶码相等。
这里有一个容易考察的结论:
对阶不会引起阶码上溢或下溢。
因为对阶只是把较小的阶码增加到较大的阶码 ,而较大的阶码本身已经是两个操作数中较大的那个阶码。只要输入浮点数本身合法,对阶过程中不会因为阶码调整而发生溢出。
但是,对阶过程中可能发生精度损失 :
对阶:小阶尾数右移,可能丢失低位精度
例如有限位尾数在右移时,最右侧的 1 可能被移出去,从而产生舍入误差。
尾数加减 完成对阶后,两个浮点数的阶码相同,可以直接进行尾数加减。
例如:
A = 1.10 1 2 × 2 3
B = 0.011 1 2 × 2 3
则:
A + B = ( 1.10 1 2 + 0.011 1 2 ) × 2 3
得到:
10.000 1 2 × 2 3
此时尾数已经不符合规格化形式,需要进行右规 。
尾数规格化 尾数运算后,需要将结果调整为规定的规格化形式。
对于二进制规格化浮点数,通常要求尾数为:
1. xxx x 2
因此,根据尾数运算结果的不同,可能进行右规 或左规 。
右规
如果尾数出现进位,例如:
10.000 1 2 × 2 3
需要将尾数右移一位:
10.000 1 2 × 2 3 = 1.0000 1 2 × 2 4
即:
右规:尾数右移,阶码加 1。
因此右规可能导致阶码上溢 。
左规
如果尾数过小,例如出现:
0.0010 1 2 × 2 3
则需要不断左移尾数,直到恢复为 1.xxxx:
0.0010 1 2 × 2 3 = 1.0 1 2 × 2 0
即:
左规:尾数左移,阶码减 1。
因此左规可能导致阶码下溢 。
所以可以直接记:
右规:尾数右移,阶码 +1 ,可能上溢
左规:尾数左移,阶码 -1 ,可能下溢
舍入 由于浮点数的尾数位数有限,在对阶、尾数运算或规格化后,如果有效位超过了规定的尾数长度,就需要进行舍入 。
常见的舍入方式包括:
需要特别注意:
舍入本身也可能产生进位,从而导致阶码增加 1。
例如,假设当前规格化尾数已经接近:
1.111 … 2
舍入后可能产生:
10.000 … 2
此时需要再次进行右规:
10.000 … 2 × 2 e = 1.000 … 2 × 2 e + 1
因此:
尾数舍入可能导致阶码 +1 ,进而可能发生阶码上溢
这也是题目中“右规和尾数舍入都可能引起阶码上溢 ”这一说法成立的原因。
溢出判断 这是浮点数加减中非常容易混淆的一点。
尾数运算产生溢出,并不意味着最终浮点数结果一定溢出。
例如两个正数相加:
1.10 1 2 × 2 3 + 1.01 1 2 × 2 3
尾数相加:
1.10 1 2 + 1.01 1 2 = 11.00 0 2
虽然尾数产生了进位,但经过右规:
11.00 0 2 × 2 3 = 1.10 0 0 2 × 2 5
只要新的阶码仍然处于可表示范围内,最终结果就是正常可表示的浮点数 。
因此:
尾数溢出时,结果不一定溢出
真正决定浮点数是否发生阶码溢出 的,是规格化、舍入等操作之后,最终阶码是否超出了可表示范围。
总结浮点数加减操作如下:
操作 尾数变化 阶码变化 可能导致 对阶 小阶尾数右移 小阶码增大 精度损失,不导致阶码溢出 尾数加减 尾数进行加减 不变 可能产生尾数进位/借位 右规 尾数右移 阶码 +1 可能阶码上溢 左规 尾数左移 阶码 −1 可能阶码下溢 舍入 尾数可能加 1 可能 +1 可能阶码上溢
2.3 - 运算电路 其实按照长时间线来看,运算电路直接考察得倒不多,但是这两年有考察增多的趋势,所以标记为中优先级。
加法运算电路 半加器 最基本的加法单元是 半加器 (Half Adder)。它有两个输入,一个是加数,一个是被加数,并有两个输出,一个是和,一个是进位。
如上图所示,通过对两个输入(A 和 B)进行 异或 (XOR)计算,可以得到 和 (S)。与 (AND)操作,可以得到 进位 (C,即 Carry)。
半加器 的主要限制是它只能对两个位进行加法,并且不能处理来自低位的进位输入。
全加器 全加器 (Full Adder)是 半加器 的扩展,它加上了前一位的 进位 (Cin)作为第三个输入,并有两个输出,一个是 和 (S),一个是 进位 (C)。
A B A ⊕ B A B C 0 0 0 0 0 1 0 1 0 0 1 1 Sum Carry 0 0 1 0 1 0 0 1 Inputs Outputs 1 0 0 1 0 1 1 1 0 1 1 1 1 0 0 1 0 1 1 1 A.B Cin Sum = Cin ⊕ (A ⊕ B) Cin . (A ⊕ B) Cout = A.B + Cin . (A ⊕ B) 半加器 用于处理两个位的简单加法,而 全加器 则可以处理包括 进位 在内的三位加法,是构建复杂加法电路的基础。
加法器 为了进行多位数的加法,全加器 可以串联起来形成一个 加法器 ,以处理多个位的二进制数加法。在这种安排中,每个 全加器 的 进位输出 连接到下一个 全加器 的 进位输入 。这样,一个 n 位的 加法器 可以通过串联 n 个 全加器 来实现。
FA FA FA A 0 B 0 A 1 B 1 A n-1 B n-1 C in C 1 C 2 C n-1 C out F 0 F 1 F n-1 上述 加法器 既可以处理 无符号加法 (unisnged),也可以处理 有符号加法 (int),因为二进制加法与数据类型无关,从 加法器 来说,只是对 0 和 1 进行操作,数据类型是对于二进制的解释方式。
一般而言,对于 有符号加法 ,加法器还需要考虑 标志位 ,所以加法器也被扩展为如下结构:
FA FA FA A 0 B 0 A 1 B 1 A n-1 B n-1 C in C 1 C 2 C n-1 (CF) C out F 0 F 1 (SF) F n-1 OF ZF 值得一提的是带符号加法器电路是如何输出各个 标志位 的,简单而言,每个 标志位 都可以通过 加法器 电路中的位信息组合得到。
ZF (zero flag):当 A+B 的结果中的每一位都为 0 时,ZF 为 1 ,所以
ZF = ! ( F 0 F 1 ⋯ F n − 1 ) SF (signed flag):A+B 的结果的正负取决于输出结果的最高位,所以
SF = F n − 1 CF (carry flag):对于 加法 ,进位即最高位,
CF = C o u t 对于 减法 ,
CF = ¬ C o u t OF (overflow flag):
OF = C n − 1 ⊕ C o u t 如果
C n − 1 C o u t 符号位 的变化导致溢出,即:一个正数加上另一个正数,结果是负数。 一个负数加上另一个负数,结果是正数。 如果 Cin 和 Cout 相同,则没有溢出发生。 减法运算电路 计算机中没有专门的减法电路,因为 补码 的 减法 可以被转换为 加法 操作:
[ A − B ] 补 = A 补 + ( − B ) 补
以下电路可以实现操作数 A 和操作数 B 的 加减法 。
如果是计算 A+B 的话,将 Sub 设置为 0,直接对 A 和 B 进行 加法 计算。
如果是计算 A-B 的话,将 Sub 设置为 1,会对 B 进行取反加一,得到
− B 补 = B 补 + 1 加法器 计算 A + (-B) 即可。
乘法运算电路 二进制乘法 与十进制乘法的手工计算方式类似:
1011 (this is binary for decimal 11)
× 1110 (this is binary for decimal 14)
======
0000 (this is 1011 × 0)
1011 (this is 1011 × 1, shifted one position to the left)
1011 (this is 1011 × 1, shifted two positions to the left)
+ 1011 (this is 1011 × 1, shifted three positions to the left)
=========
10011010 (this is binary for decimal 154)
在计算机中实现 乘法指令 可以通过如下几种方式模拟以上过程:
软件算法 如果没有专有硬件支持,可以通过一系列 加法 和 位移 操作来实现 乘法 。编译器将 乘法运算 转换为一个循环代码段,在循环代码段中通过比较、加法 和移位等指令实现 乘法运算 。
// 如何使用加法和位移来实现两个整数的乘法(了解即可)
unsigned int multiply ( unsigned int a , unsigned int b ) {
unsigned int result = 0 ; // 结果初始化为 0
while ( b > 0 ) { // 当第二个操作数大于 0 时继续循环
if ( b & 1 ) { // 检查 b 的最低位是否为 1
result += a ; // 如果是,将 a 加到结果上
}
a <<= 1 ; // 将 a 左移一位,相当于 a 乘以 2
b >>= 1 ; // 将 b 右移一位,去掉已经处理过的最低位
}
return result ; // 返回计算的乘积
}
顺序乘法器 通过硬件的方式串行地模拟手工计算的方式,无符号数的 乘法硬件电路 如下图所示(了解即可):
32 位 ALU 被乘数寄存器 X 乘积寄存器 P 乘积寄存器 Y 加 控制逻辑 计数器 C n 64 位 32 32 32 32 右移 C 其思路是通过 右移 和 加法 ,每次输出 乘法结果 中的一位,由于原理稍复杂,这里不阐述更多细节。
阵列乘法器 阵列乘法器 (Array Multiplier)是一种用于执行 乘法运算 的硬件电路,它通过布置一系列 全加器 和 半加器 在一个二维网格或阵列中来实现,它能够并行处理多个位的 乘法 和 累加 ,可以在一个或多个时钟周期内完成 乘法操作 。
除法运算电路 二进制 除法 在计算机中的实现与我们在十进制中所执行的传统 除法 类似。
00111 商 = 0111 = 7
----------
0010 | 00001111 被除数 X = 15 = 1111 = 00001111
0010 除数 Y = 2 = 0010
-----
0011
0010
-----
0011
0010
----
0001 余数 = 0001 = 1
二进制 除法 可以被总结为如下步骤:
准备 :将被除数和除数都转换为二进制形式。 写下被除数和除数,类似于十进制除法的长除法形式。 除法 :从被除数的最高位开始,与除数进行比较。 如果被除数当前部分大于或等于除数,则商为 1,否则商为 0。 如果商为 1,则将被除数当前部分减去除数,并将差写在下面。 将被除数的下一位数字移下来,与差组成新的被除数部分。 重复上述步骤,直到被除数的每一位都被处理完毕。 余数 :最后一次减法运算得到的差即为余数。 如果最后一次减法得到的差是 0,则表示整除,没有余数。 简单的 除法电路 结构也是通过模拟以上过程实现(了解即可):
32 位 ALU 除数寄存器 Y 余数寄存器 R 余数/商寄存器 Q 加/减 控制逻辑 计数器 C n 64 位 32 32 32 32 左移 写使能 在 除法电路 中,在每次迭代中我们将当前 余数 左移一位,并引入 被除数 的下一位,然后执行 余数减去除数 的操作,接下来通过条件判断检测 减法结果 的符号以确定 商 的当前位。
在每次迭代中,我们可以输出 除法结果 中的一位,重复直到处理完所有位后,可以得到 商 和 余数 的结果。
2.4 - 类型转换 常在选择题考查,其实就 四点 :有符号和无符号整数之间的转换,整形和浮点数的转换,不同长度类型的转换,隐式和显式的转换。
有符号整数和无符号整数 当 有符号整数 和 无符号整数 之间相互转换时,二进制数据 不变,只是改变了变量(或数字)的类型。
首先需要了解 有符号整数 (int)和 无符号整数 (unsigned)这两个类型:
int:使用 补码 来存储数据。unsigned:所有位,包括最高位,都用于表示数值,表示非负数。在现在的 64 位计算机中,一般 int 表示 32 位 有符号整数 ,unsigned 表示 32 位 无符号整数 。int 和 unsigned 在不同体系计算机中行为不同,所以 C 语言库中也自带 int32_t 、uint32_t 这种类型来表示特定位数的 有符号 和 无符号 整数,并在各计算中行为一致。
这里为了方便说明,以 8 位 有符号整数 和 无符号整数 为例:
8 位 有符号整数 表示的范围为 -128 ~ 127 最大数为127,对应的二进制为0111 1111 最小数为-128,对应的二进制为1000 0000 8 位 无符号整数 表示的范围为 0 ~ 255 最大数为255,对应的二进制为1111 1111 最小数为0,对应的二进制为0000 0000 当 int 和 unsigned 进行 类型转化 时,位模式 不变,可以理解成计算机存储单元中的二进制表示没有变化,只是从程序层面阐述该二进制数据的方式变了,如下图所示:
SignedUnsignedConversion cluster_signed 有符号整数 (int8) cluster_unsigned 无符号整数 (uint8) s_min -128 (1000 0000) u_128 128 (1000 0000) s_min->u_128 位模式相同 1000 0000 s_minus1 -1 (1111 1111) u_255 255 (1111 1111) s_minus1->u_255 位模式相同 1111 1111 s_zero 0 (0000 0000) u_min 0 (0000 0000) s_zero->u_min 位模式相同 0000 0000 s_max 127 (0111 1111) u_127 127 (0111 1111) s_max->u_127 位模式相同 0111 1111 整形和浮点数 在计算机中,整形 (short, int, long)和 浮点数 (float, double)之间可以相互转换,但是在转换的过程中可能出现 精度丢失 或 数据溢出 。
下图汇总了 整形 和 浮点数 在不同方向上转换时的风险类别:
整型 ⇄ 浮点数 类型转换风险矩阵 源类型 \ 目标类型 int (32 位) float (32 位) double (64 位) int 补码,± 2^31 — 同类型 精度可能丢失 |x| > 2^24 时舍入 尾数仅 23 位 精确 double 52 位尾数 覆盖整个 int 范围 float IEEE 754, 32 位 截断小数 + 可能溢出 超出 int 范围未定义 — 同类型 精确 double 范围/精度更高 double IEEE 754, 64 位 截断小数 + 可能溢出 |x| > 2^31 未定义 精度丢失 / 溢出 超 float 范围 → ±∞ 尾数从 52 位 → 23 位 — 同类型 精确 / 无损 舍入 (精度丢失) 截断 (丢失小数) 溢出 / 未定义
整形转浮点数 如果一个整数被转换为浮点数,其结果是否会产生 精度丢失 取决于整数的大小是否超过浮点数可以精确表示的整数范围。精度损失 。
比如对于 float 类型,其尾数为 23 位,它可以精确表示的整数范围为
( − 2 24 , 2 24 ) int 类型的数字在这个范围内,则将其转换为 float 时 不会丢失精度
但是如果 int 类型数字超出这个范围且低 8 位不全为 0 的话,则将其转换为 float 会有 精度丢失 。
浮点数转整数 当 浮点数 被转换为 整数 时,小数部分会丢失,因为 整数 不能表示小数。
此外,如果 浮点数 超出了 整形 的表示范围,转换可能会 溢出 或产生未定义行为(取决于语言)。
不同长度的类型转换 类型 最小位数 常见位数(32 位系统) 常见位数(64 位系统) char8 位 8 位 8 位 short16 位 16 位 16 位 int16 位 32 位 32 位 long32 位 32 位 64 位 long long64 位 64 位 64 位 float- 32 位 32 位 double- 64 位 64 位
总结 一下不同长度的 整数 和 浮点数 的 类型转换 规则:
整数和整数 较小的 整数类型 被转换为较大的 整数类型 时,高位会被自动填充为 0 或 1,不会有数据丢失。 较大的 整数类型 被转换为较小的 整数类型 时,高位会被自动截断,可能有数据丢失。 浮点数和浮点数 float 转为 double 时,不会有 精度丢失 ,double 转为 float 时,可能有 精度丢失 。以 short 和 int 的类型转化为例说明:
/* 将 short 转为 int */
short s = 0x1234 ;
int i = s ;
// 高 16 位被填充为 0
// i = 0x00001234
/* 将 int 转为 short */
int i = 0x12345678 ;
short s = i ;
// 高 16 位被截断
// s = 0x5678
类型转换语法 在编程中,类型转换 指的是将一种数据类型转换为另一种数据类型。主要分为两种:
隐式类型转换 (Implicit Type Conversion)显式类型转换 (Explicit Type Conversion)(也称为 强制类型转换 ,Type Casting)TypeConversion cluster_implicit 隐式转换示例 cluster_explicit 显式转换示例 title 类型转换 (Type Conversion) implicit 隐式类型转换 (Implicit Type Conversion) 自动进行 title->implicit explicit 显式类型转换 (Explicit Type Conversion) 手动指定 title->explicit implicit_entry implicit->implicit_entry explicit_entry explicit->explicit_entry int_var int i = 5 implicit_entry->int_var conversion1 i 自动转换为 5.0 int_var->conversion1 低精度→高精度 float_var float f = 2.5 result1 float result = i + f 结果: 7.5 float_var->result1 conversion1->result1 float_var2 float f = 3.2 explicit_entry->float_var2 int_var2 int i = 5 result2 int result = (int)f + i 结果: 8 int_var2->result2 conversion2 (int)f 强制转换为 3 float_var2->conversion2 强制转换 conversion2->result2 warning 可能发生精度缺失! conversion2->warning 隐式类型转换 在 C 语言中,当算术运算、赋值或比较表达式涉及不同的数据类型时,如果没有显式指定转换方式,编译器会按照 C 语言规定的类型转换规则自动完成 类型转换 。
/* 隐式类型转换 */
int i = 5 ;
float f = 2.5f ;
float result = i + f ; // i 被隐式转换为 5.0f,然后进行计算
例如,在一个表达式中混合使用 int 和 float 时,编译器会自动将 int 转换为 float,使两个操作数具有兼容的数据类型后再进行计算。实际采用哪种转换方式由 C 语言的类型转换规则决定,而不是简单地按照数据类型的精度高低进行转换。
显式类型转换 也可以使用 类型转换运算符 显式地将一个数据类型转换为另一个数据类型。
/* 显式类型转换 */
int i = 5 ;
float f = 3.2f ;
int result = ( int ) f + i ; // f 被显式转换为 3,然后与 i 相加
显式类型转换 会按照程序员指定的目标类型进行转换。在转换过程中,可能发生 精度损失 、数据截断 ,甚至 数值溢出 ,因此应谨慎使用。
3 - 存储系统 本章是重中之重,在选择题和大题中每年都会考察,需要理解通透。其中 cache 和虚拟存储器常常和操作系统中的相关知识放在一起考察,需要能够将两门课相关内容联系起来。
# 存储器层次结构
## 存储器分类
## 层次化存储器的基本结构
## 半导体随机存取存储器
- SRAM存储器
- DRAM存储器
- Flash存储器
## 主存储器
- DRAM芯片和内存条
- 多模块存储器
- 主存和CPU之间的连接
## 外部存储器
- 磁盘存储器
- 固态硬盘
## 高速缓冲存储器
- cache的基本原理
- cache和主存之间的映射方式
- cache中主存块的替换算法
- cache写策略
## 虚拟存储器
- 基本概念
- 页式虚拟存储器
- 段式虚拟存储器
- 段页式虚拟存储器
3.1 - 存储系统 存储器的概念经常在选择题中考察,需要了解常见存储器的类型和特点,在选择题中看见相关名词能够辨识选出正确答案。
存储系统的层次结构 存储系统是计算机体系结构的核心组成部分之一,用于存储程序指令和数据,以支持处理器的运算需求。为了平衡速度、容量和成本,现代计算机采用了分层存储体系结构,从最快速但容量有限的 寄存器 到容量大但速度较慢的辅助存储设备,形成了存储层次结构。
Local secondary storage
Remote secondary storage
如上图所示,越靠近金字塔上层的容量越小但速度越快,越靠近金字塔下层的容量越大但速度越慢。计算机的存储系统包含以下层次:
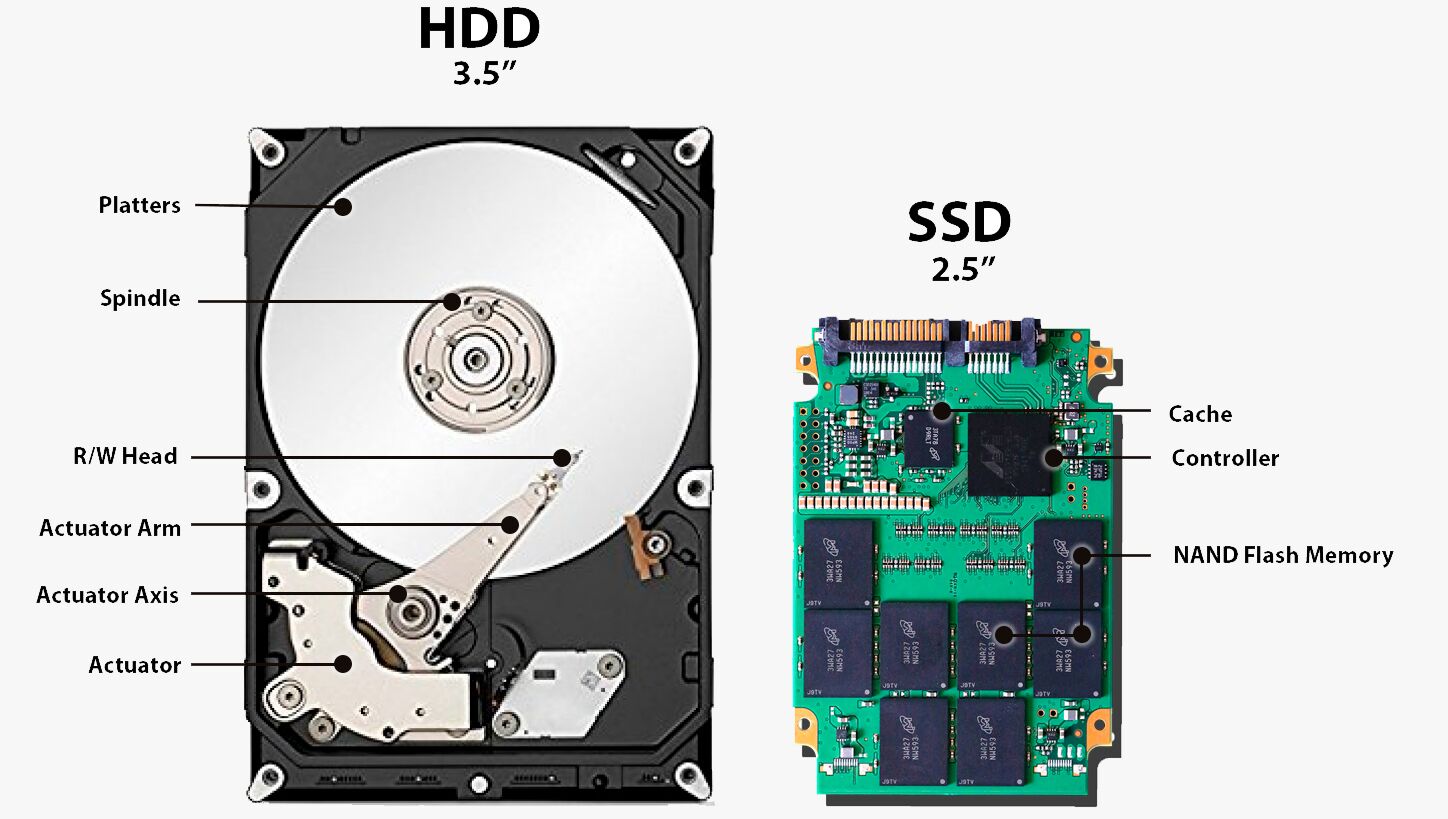
寄存器(Registers) 寄存器是位于处理器内部的最快速存储单元。 它们提供极快的数据访问速度,但其容量非常有限。 典型访问延迟 :约 0.2~1 ns (通常只需 1 个 CPU 时钟周期 )。一级缓存(L1 Cache) L1 缓存位于处理器内部,比寄存器空间稍大,速度比 L2 和 L3 Cache 更快。 它通常分为 数据缓存 (用于存储数据)和 指令缓存 (用于存储指令)。 典型访问延迟 :约 0.5~1.5 ns (约 2~5 个 CPU 时钟周期 )。二级缓存(L2 Cache) L2 缓存比 L1 缓存大,并且位于处理器和主内存之间。 它的速度比 L1 慢,但比主内存快。 典型访问延迟 :约 2~5 ns (约 10~20 个 CPU 时钟周期 )。三级缓存(L3 Cache) 在某些系统中,还有 L3 缓存,这是一种更大但速度更慢的缓存。 它位于 L2 缓存和主内存之间,旨在进一步减少对主内存的访问。 多个 CPU 核心通常共享同一个 L3 Cache。 典型访问延迟 :约 10~20 ns (约 30~70 个 CPU 时钟周期 )。主存(RAM) 就是我们常说的内存,比缓存慢,但比硬盘快得多,并且容量比缓存大。 主存 用于存储正在运行的程序和当前使用的数据。典型访问延迟 :约 50~100 ns (约 150~300 个 CPU 时钟周期 )。辅助存储(如硬盘驱动器或固态驱动器) 辅助存储设备提供大量的永久存储。 与 RAM 相比,这些设备访问速度较慢,但能够存储更多的数据,并且在断电时不会丢失数据。 机械硬盘 (HDD)和 固态硬盘 (SSD)是常见的辅助存储设备。典型访问延迟 :NVMe SSD :约 20~100 μs (微秒)SATA SSD :约 50~200 μs 机械硬盘(HDD) :约 5~15 ms (毫秒)可以发现,相邻两层存储器之间通常都存在 数倍甚至数十倍 的速度差异。例如,从 L3 Cache 访问数据只需十几纳秒,而访问 主存 往往需要几十纳秒;如果数据需要从 SSD 或 HDD 中读取,则访问时间又会增加到微秒甚至毫秒级,相比 Cache 慢了数千到数百万倍。因此,如果 CPU 每次访问数据都直接访问主存或磁盘,将会有大量时间处于等待状态,计算能力无法得到充分发挥。
存储器层次结构的主要思想是:上一层存储器作为下一层存储器的高速缓存 。当 CPU 要读取某个数据时,会优先在速度最快的存储器中查找:
先访问 Cache ; 如果 Cache 中没有(发生 Cache Miss ),则访问 主存 ; 如果 主存 中也没有,则访问磁盘,此时数据会先从磁盘调入 主存 ,再从 主存 调入 Cache ,最后供 CPU 使用。 Cache—主存层 主要解决 CPU 和主存之间巨大的速度差异问题。主存和 Cache 之间的数据调动完全由 硬件自动完成 ,程序员通常无需关心数据何时进入或离开 Cache 。
主存—辅存层 主要解决存储系统容量不足的问题。主存和 辅存 之间的数据调动由 硬件和操作系统共同完成 (例如虚拟内存、分页机制),对于应用程序员来说也是透明的 。程序只需按照统一的地址空间访问数据,而无需关心数据当前位于主存还是磁盘中。
RAM 半导体随机存储器的英文为 Semiconductor Random-Access Memory(RAM)。
RAM · Random-Access Memory 随机存储器 半导体 · 随机访问 · 易失性 · 运行时存储 内存条 (DIMM) 示意 DRAM DRAM DRAM DRAM DRAM DRAM ⚡ 随机访问 · 恒定时延 易失 · 掉电数据丢失 「随机访问」是什么? 0x00 0x01 0x02 0x03 0x04 0x05 0x06 直接寻址 对比:磁带/磁盘 顺序访问 ① ② ③ ④ ⑤ ⑥ ⑦ 必须按顺序逐个读取 RAM 的两大分类 SRAM Static RAM · 静态随机存储器 • 存储单元:4-6 个晶体管 (触发器) • 速度:快 • 功耗:静态低 • 成本高 · 集成度低 · 容量小 • 无需刷新 用途 CPU Cache 寄存器 DRAM Dynamic RAM · 动态随机存储器 • 存储单元:1 晶体管 + 1 电容 (1T1C) • 速度:较慢 • 功耗:刷新带来动态功耗 • 成本低 · 集成度高 · 容量大 •需周期性刷新 (电容漏电) 用途 主内存 显存 首先说明这个名称中各部分的含义:
半导体 :这种存储器使用硅等半导体材料制造,晶体管是构成半导体存储器的基本器件。随机访问 :可以通过地址直接访问存储器中的任意位置,并且访问不同位置所需的时间基本相同。它不同于磁带等需要按照顺序查找数据的存储设备。随机存储器主要分为 SRAM 和 DRAM 两种。
SRAM SRAM (Static RAM,静态随机存取存储器)使用触发器构成基本存储单元。一个 SRAM 存储单元通常由 4~6 个晶体管 组成,用于存储 1 bit 数据,如下图所示:
只要电源持续供应,触发器的状态就可以一直保持,因此 SRAM 不需要刷新 。
SRAM 主要用于 CPU 的 Cache(L1/L2/L3) 、寄存器文件以及嵌入式系统中的小容量高速存储器。
DRAM DRAM (Dynamic RAM,动态随机存储器)使用 1 个晶体管(Transistor) 和 1 个电容器(Capacitor) ,即 1T1C 结构,构成基本存储单元。每个存储单元存储 1 bit 数据。
与 SRAM 使用触发器保存状态不同,DRAM 利用电容器中是否存有电荷表示数据。由于电容器会随着时间不断漏电,因此数据不能永久保持,必须定期进行 刷新(Refresh) ,重新恢复电容器中的电荷。
DRAM 具有 集成度高、成本低、容量大 等特点,因此主要用于计算机的 主存 、显卡显存等大容量存储设备。
二维阵列与行列地址 DRAM 和 SRAM 在宏观上都采用 二维存储阵列 组织数据,并通过字线和位线访问存储单元。二者的主要区别在于所使用的 基本存储单元 不同。
DRAM 中:
每个 存储单元(Cell) 只能存储 1 bit 数据; 电容器(Capacitor) 用于保存电荷:晶体管(Transistor) 相当于一个开关,由 字线(Word Line) 控制;由于一个 Cell 只能保存 1 bit 数据,而计算机通常一次需要读写多个 bit,因此一个 可寻址地址(Addressable Location) 往往对应多个 Cell 共同组成。
例如,一个 4 bit 宽的 DRAM 芯片,每个可寻址地址对应 4 个 Cell ,分别存储这 4 个 bit。为了实现这一点,DRAM 内部通常采用 多个位平面(Bit Plane) 并行工作的组织方式。
每个位平面都是一个独立的 二维 Cell 阵列 ,其中的每个 Cell 存储 1 bit 数据。所有位平面具有完全相同的行、列结构,并共享相同的 行地址(Row Address) 和 列地址(Column Address) 。
当访问某个地址时,控制器利用相同的行地址和列地址,在所有位平面中同时选中对应位置的 Cell。每个位平面分别读出(或写入)1 bit 数据,最终组合成该地址对应的 4 bit 数据。
1 位平面 0 (LSB) 0 1 1 位平面 3 (MSB) 行地址 (Row) 列地址 (Col) Cell (存储单元) 物理存储的最小单位 仅存储 1 bit Bit Plane (位平面) 独立的二维 Cell 阵列 负责该地址的其中 1 bit Addressable Location (可寻址地址) 同一 (行, 列) 在各位平面中的 Cell 被同时选中并组合成一次访问的数据 1 1 0 1 bit3 bit2 bit1 bit0 1 个地址 → 4 bit 数据 位平面 (Bit Plane) 被同一 (行,列) 选中的 Cell 需要区分两个概念:
Cell(存储单元) :物理存储的最小单位,只能存储 1 bit 。Address(可寻址地址) :也可以叫做 memory location,指的是 CPU 或内存控制器访问 DRAM 的逻辑单位,一个地址可以对应多个 Cell(如 4 bit、8 bit、16 bit 等)。DRAM 对外提供的是可寻址地址(Address)。
为了提高存储密度,DRAM 将每个 bit 的存储单元组织成二维 Cell 阵列。访问某个地址时,控制器首先将地址划分为 行地址(Row Address) 和 列地址(Column Address) ,利用这两部分地址在所有 Cell 阵列中同时选中相同位置的 Cell。
假设每个 Cell 阵列共有
R C
行地址需要
log 2 R 列地址需要
log 2 C 因此,一个可寻址地址共需要
log 2 R + log 2 C
位。
这里的 行地址(Row Address) 和 列地址(Column Address) 是 DRAM 芯片内部 用于定位数据的位置,并不是 CPU 发出的主存地址。
CPU 访问的是整个主存空间中的 物理地址 ,而 内存控制器 会将该地址转换为 DRAM 内部使用的行地址和列地址,再完成数据访问。因此,教材中讨论 DRAM 时通常只关注 DRAM 内部的地址组织方式 ,而不涉及 CPU 地址到 DRAM 地址的映射过程。
一种典型的实现方式可以理解为由 4 个位平面(Bit Plane) 组成,每个位平面都是一个独立的 Cell 阵列 ,负责存储其中 1 bit 数据。
若每个位平面都组织为:
256 行 × 256 列
则:
每个位平面共有
256 × 256 = 64 K 行地址需要 8 位 ; 列地址需要 8 位 ; 一个可寻址地址由 8 位行地址 和 8 位列地址 组成,共 16 位 。 访问某个地址时,控制器首先根据地址得到对应的 行地址 和 列地址 ,然后利用相同的行地址和列地址,同时访问 4 个位平面中对应位置的 Cell。每个位平面分别读出(或写入)1 bit 数据,最终组合成该地址对应的 4 bit 数据。
因此,对于 64K × 4 bit 的 DRAM:
64K 表示共有 64K 个可寻址地址 ;4 bit 表示每个地址对应 4 个位平面中的 4 个 Cell ,共同组成该地址的数据。行列地址复用 如果将完整地址一次性送入上述 DRAM 芯片,就需要设置 16 根地址引脚 。
但是,DRAM 芯片通常容量较大。如果每一位地址都使用一根独立引脚,芯片所需的引脚数量会很多,从而增加封装面积和制造成本。
为了减少地址引脚数量,DRAM 通常采用 行列地址复用(Address Multiplexing) :
使用同一组地址引脚,先传送行地址,再传送列地址。
DRAM 行列地址复用 (Address Multiplexing) 同一组地址引脚分两次传送:先送行地址 (RAS),再送列地址 (CAS) CPU 地址 A0 ~ A11 12 根地址线 ① RAS:行地址 ② CAS:列地址 时序示意 RAS CAS ADDR Row Col DRAM 芯片 行地址锁存器 Row Address Latch 列地址锁存器 Column Address Latch 行 译码器 列译码器 / 灵敏放大器 cell 位线 (Bit Line) → 字线 ↓ 选中行 A[11:0] 分时复用 引脚对比 不复用 12 行 + 12 列 = 24 根地址线 复用 同一组地址线分时 = 12 根地址线 引脚数量减半 降低封装成本与面积 SRAM 通常不采用行列复用:容量小、追求速度,地址一次性给出直接译码。 地址访问过程如下:
内存控制器先在地址引脚上送入 行地址 ; 通过 RAS(Row Address Strobe,行地址选通信号) 将行地址锁存到 DRAM 内部; DRAM 根据行地址激活对应的行; 内存控制器再使用同一组地址引脚送入 列地址 ; 通过 CAS(Column Address Strobe,列地址选通信号) 将列地址锁存; DRAM 根据列地址,从已经激活的行中选择相应的数据。 因此,行地址和列地址虽然使用相同的引脚传输,但会在不同的时刻分别送入。
采用行列地址复用后,DRAM 所需的地址引脚数量约为:
max ( log 2 R , log 2 C )
当行地址位数和列地址位数相同时,只需要原来大约一半的地址引脚。
以前面的 64K × 4 bit DRAM 为例:
不采用地址复用:需要 16 根地址引脚 ; 采用地址复用:只需要 8 根地址引脚 ; 这 8 根地址引脚先传输 8 位行地址,再传输 8 位列地址。 DRAM 行列复用实例 假设有一个 16M × 4 bit 的 DRAM 芯片,共有:
16 M = 2 24
个可寻址位置,每个地址可以读写 4 bit 数据。
如果将这些地址组织为:
4 K 行 × 4 K 列
由于:
4096 × 4096 = 2 12 × 2 12 = 2 24 = 16 M
因此:
行地址需要 12 位 ; 列地址需要 12 位 ; 完整地址需要 24 位 。 如果不采用地址复用,需要 24 根地址引脚 ;采用行列地址复用后,只需要 12 根地址引脚 。
这 12 根地址引脚首先传送行地址,随后再传送列地址。
SRAM 内部通常也会将存储单元组织成二维阵列,并使用 行译码器 和 列选择电路 访问具体的存储单元。因此,从内部结构来看,SRAM 同样存在行、列的划分。
但是,普通 SRAM 芯片一般 不采用 DRAM 式的行列地址分时复用 。
SRAM 通常会在地址引脚上一次性接收完整地址:
CPU 或内存控制器一次性送入完整地址; SRAM 内部将地址拆分为行地址和列地址; 行译码器和列选择电路同时完成地址译码; 直接读取或写入对应的数据。 也就是说,SRAM 和 DRAM 的区别不在于内部是否存在行列结构,而在于 外部地址的传输方式 :
存储器 内部组织方式 外部地址传输方式 DRAM 二维阵列,分为行和列 通常先传行地址,再使用同一组引脚传列地址 SRAM 二维阵列,分为行和列 通常一次性传入完整地址,由芯片内部拆分和译码
SRAM 一般不采用行列地址复用,主要有以下原因:
SRAM 的容量通常比 DRAM 小,所需地址引脚相对较少; SRAM 更强调访问速度,一次性输入完整地址可以减少地址传输和锁存步骤; SRAM 不需要 RAS、CAS 这样的行列地址锁存过程,控制方式更加直接。 因此:
DRAM 的行列地址复用主要是为了减少芯片引脚数量,但会增加地址传输步骤;SRAM 通常一次性接收完整地址,以获得更低的访问延迟。
刷新机制 由于 DRAM 使用 电容器 保存数据,而电容会不断漏电,因此即使 CPU 完全没有访问某个存储单元,其中保存的数据也会随着时间逐渐消失。
为了保证数据正确,内存控制器(Memory Controller) 必须在规定时间内,通常是几十毫秒内,保证 每一行 至少被刷新一次。
① 问题:电容漏电,数据会消失 刚写入 + + + 1 (满电荷) 时间流逝 电容漏电 几十 ms 后 + ? (电荷不足) 电荷 vs 时间 0 t Q 阈值 跌破阈值 → 无法判定 0/1 ② 解决:由内存控制器周期性刷新 内存控制器 Memory Controller 发出刷新命令 DRAM 阵列 在规定时间内每行刷新一次 刷新本质:读出一行 → 感应放大 → 写回同一行 1. 读取 激活字线 读出微弱信号 2. 感应放大 Sense Amplifier 恢复为 0/1 3. 写回 重新充电到 满电荷状态 ③ 刷新单位是"行":同一字线上的所有 Cell 一次性刷新 字线 Row 0 Row 1 Row 2 Row 3 ★ Row 4 ... Row n-2 Row n-1 感应放大器阵列 (Sense Amplifier Row) 位线 → 每列一条 为什么按行刷新? • 同一行的所有 Cell 共享一条字线 • 激活一次字线,整行 Cell 全部导通 • 每列的感应放大器同时读出并写回 • 一次刷新 = 恢复整行电荷 约束条件 • 刷新周期通常为64 ms 左右 • 期间必须保证每一行至少刷新 1 次 • 正被刷新的存储体无法响应读/写请求 所谓 刷新(Refresh) ,本质上是读取一行存储单元中的数据,并利用感应放大器将这些数据重新写回,从而恢复电容器中的电荷。
由于 DRAM 的存储阵列按行和列组织,同一行上的所有存储单元共享一条字线,因此刷新操作也是 按行进行的 。一次刷新会恢复整行存储单元中的电荷,而不是逐个存储单元进行刷新。
刷新期间,被刷新的存储体不能正常提供读写服务,因此不同的刷新策略会直接影响 DRAM 的访问性能。
刷新方式 DRAM 常见的刷新方式包括:
集中刷新(Burst Refresh) :在一个刷新周期内,集中安排一段时间连续刷新所有行。控制简单,但连续刷新期间无法进行正常访问,会形成较长的停止访问时间。分散刷新(Distributed Refresh) :将刷新操作分散到各个 存储周期 中,使刷新操作与正常读写操作规律地交替进行。不会形成很长的集中停顿,但会频繁占用存储周期。异步刷新(Asynchronous Refresh) :在整个刷新周期内均匀安排刷新操作,每隔一定时间刷新一行。它避免了集中刷新的长时间停顿,同时又不要求每个存储周期都执行刷新,是集中刷新和分散刷新的一种折中方式。三种刷新方式在时间轴上的 CPU 等待窗口对比如下图所示:
DRAM 三种刷新方式 · 时间轴对比 CPU 访问 刷新操作 CPU 等待 (无法访问) ① 集中刷新 所有行集中在死区刷新,CPU 长时间等待 集中刷新 (CPU 死区) ② 分散刷新 每个存取周期 = 访问 + 一次刷新,无死区但周期翻倍 ③ 异步刷新 每 (T_ref / N行) 时间触发一次单行刷新,CPU 等待窗口最小 单行刷新 时间 → 它们的特点如下:
特征 集中刷新 分散刷新 异步刷新 刷新方式 在一段时间内连续刷新所有行 刷新与正常访问逐周期交替 每隔一定时间刷新一行 CPU 等待 等待时间长,但集中出现 每次等待时间短,但非常频繁 等待时间短,并且均匀分布 对性能影响 存在明显的停止访问时间 持续占用部分存储周期 通常比前两种方式更加均衡 控制复杂度 低 中 较高 典型特点 存在“死时间” 没有长时间停顿,但刷新频繁 集中刷新与分散刷新的折中
SRAM 对比 DRAM SRAM Static Random-Access Memory 存储单元:6 晶体管触发器 (6T) WL BL BL̅ 数据保持:触发器闩锁,通电即稳 刷新:无需刷新 速度:极快(约 1–5 ns) 集成度:低(每 bit ≥ 6 管) 功耗:静态低,切换高 成本:高 典型用途:CPU Cache、寄存器 DRAM Dynamic Random-Access Memory 存储单元:1 晶体管 + 1 电容 (1T1C) WL BL C 漏电 数据保持:电容存电荷,会漏电 刷新:需定期刷新(毫秒级) 速度:较慢(约 50–100 ns) 集成度:高(每 bit 1 管 1 容) 功耗:刷新+读写有持续开销 成本:低 典型用途:主存、显存 VS 特性 DRAM SRAM 存储单元 1 个晶体管 + 1 个电容器(1T1C) 4~6 个晶体管组成的触发器 数据保持方式 使用电容器保存电荷 使用触发器保持状态 是否需要刷新 需要定期刷新 无需刷新 内部阵列 通常采用二维行列阵列 通常也采用二维行列阵列 外部地址输入 通常采用行列地址复用 通常一次性输入完整地址 访问速度 较慢 更快 集成度 高 较低 成本 低 高 容量 大 小 典型应用 主存、显存 CPU Cache、寄存器文件
ROM ROM (Read-Only Memory,只读存储器)是一类 非易失性(Non-Volatile) 存储器,断电后仍能保存数据,主要用于存放系统启动程序、固件(Firmware)以及其他长期不需要频繁修改的数据。
ROM · Read-Only Memory 只读存储器 非易失性 · 主要用于读取 · 存放固件与启动程序 ROM BIOS / Firmware 非易失性 以读为主 断电后数据保留 ⚡ 断电 数据仍在 ✎ 写入 受限/不可 ROM vs RAM ROM RAM 易失性 否(持久) 是(掉电丢失) 读写 主要只读 可随机读写 典型用途 固件 / BIOS 运行时数据 容量 较小 较大 ROM 家族 (Evolution) M MROM 掩膜式 出厂固化 P PROM 一次可编程 熔丝烧写 E EPROM 紫外线擦除 可重复编程 EE EEPROM 电擦写 字节级可改 F Flash 块擦写 SSD / U盘 典型场景 · 开机加电后 CPU 加电 从 ROM 读取 BIOS 硬件自检 / 引导 加载操作系统至 RAM 虽然名称叫做 只读存储器(Read-Only Memory) ,但这里的"只读"是相对于 正常工作状态 而言的。
在计算机运行过程中,CPU 可以 随机读取(Random Access) ROM 中任意地址的数据; 但一般不能像 RAM 一样随时写入数据。 某些现代 ROM(如 EPROM、EEPROM、Flash)虽然支持重新编程,但写入通常需要专门的硬件、电压或擦除操作,写入速度也远低于 RAM。 因此,现代教材中的 ROM 更准确地理解为 非易失性存储器 ,而不是绝对不能写入的存储器。
ROM 最典型的用途是存储 固件(Firmware) 。固件是直接嵌入硬件中的底层程序,负责设备初始化和基本控制。例如:
PC 主板中的 BIOS/UEFI 路由器、交换机中的启动程序 各种嵌入式设备(单片机、家电、汽车 ECU)的控制程序 ROM 对比 RAM 特征 RAM(随机存取存储器) ROM(只读存储器) 易失性 易失性 ,断电后数据丢失非易失性 ,断电后数据仍保留读写能力 可随机读、随机写 可随机读,一般不能在运行过程中随机写 数据修改 可频繁修改 一般很少修改,需要专门方式写入 访问速度 较快 通常慢于 RAM 用途 存放正在运行的程序和数据 存放固件、启动程序、固定数据 容量 一般较大 一般较小
需要注意:
RAM 和 ROM 都支持随机存取(Random Access) ,区别并不在于是否能够随机访问,而在于 是否能够方便地写入以及是否断电保存数据 。
分类 主要了解下面几种 ROM。
MROM MROM (Mask ROM,掩膜 ROM)是在芯片制造过程中直接写入数据的 ROM。
其内容在出厂后便无法修改,因此成本低、可靠性高,适合大批量生产。
光刻掩膜(永久图案) 制造时写入 固定程序 内容永久固定 出厂后不可修改 写一次,用终生 成本低 · 可靠性高 适合大批量生产 典型应用 早期游戏卡带 / 固定程序 PROM PROM (Programmable ROM,可编程 ROM)允许用户在出厂后 写入一次数据 。
一旦完成编程,就无法再次修改,因此又称 一次性可编程 ROM(OTP,One-Time Programmable) 。
出厂时(空白) 所有熔丝完好 = 全 1 高压脉冲 烧断熔丝 编程一次后 断开的熔丝 = 数据固定 用户烧录 出厂后再写入内容 仅可写入一次 OTP · One-Time Programmable 写入后不可逆 熔丝烧断无法恢复 EPROM EPROM (Erasable Programmable ROM,可擦除可编程 ROM)可以通过 紫外线照射 将整个芯片中的数据全部擦除,然后重新写入。
其特点是:
可以反复编程; 必须取下芯片并使用紫外线擦除; 擦除时间较长,操作较为繁琐; 支持随机读取。 早期 PC 的 BIOS 芯片曾大量采用 EPROM。
① 紫外线照射擦除 ☀ 石英窗口暴露芯片 ② 整片擦除为空白 全部恢复为 1 专用编程器 ③ 重新写入数据 加电压逐位写入 紫外线擦除 整片恢复为空白状态 可反复编程 需取下芯片,操作繁琐 典型应用 早期 PC BIOS 芯片 EEPROM EEPROM (Electrically Erasable Programmable ROM,电可擦除可编程 ROM)使用 电信号 完成擦除和写入,不再需要紫外线。
相比 EPROM:
不需要拆卸芯片; 可以在电路板上直接更新内容; 支持按字节(Byte)擦除和写入; 写入速度较慢,擦写次数有限。 在电路板上原地更新 配置数据 无需拆卸芯片 电信号 按字节擦写 按字节(Byte)擦除/写入 改写 其余字节保持不变 电信号擦写 不需要紫外线设备 电擦除,无需紫外线 支持按字节擦写 局限 写入较慢,擦写次数有限 Flash Flash Memory(闪存) 是 EEPROM 的一种改进形式,也是现代最广泛使用的非易失性存储器。
Flash 存储器 · Floating-Gate 浮栅晶体管 非易失性 · 电擦写 · 用于 SSD / U盘 / 手机存储 浮栅晶体管 (Floating Gate MOSFET) CG Control Gate · 控制栅 Floating Gate · 浮栅 e⁻ e⁻ e⁻ e⁻ 隧穿氧化层 Source 源极 (S) Drain 漏极 (D) P-Substrate (硅衬底) 隧穿 e⁻ 有电荷 表示 逻辑 0 无电荷 表示 逻辑 1 三种基本操作 读 Read 检测阈值电压 速度快 ⚡ 单元级 写 Program 注入电子到浮栅 1 → 0 页级写入 擦 Erase 抽走电子,全置 1 0 → 1 块级擦除 两大类型 NAND Flash 串联结构 · 密度高 顺序读快 · 容量大 SSD · U盘 · SD卡 NOR Flash 并联结构 · 可随机读 支持就地执行 (XIP) BIOS · 嵌入式固件 速度 / 性能定位 RAM 最快 Flash 中等(比 HDD 快得多) HDD 最慢 优势: 非易失 · 无机械结构 · 抗震 · 低功耗 · 体积小 · 速度远超机械硬盘与 EEPROM 相比:
按块(Block)擦除 ,因此速度更快;存储密度更高; 成本更低; 擦写寿命有限(通常几千到几十万次)。 目前大量设备都采用 Flash 存储,例如:
SSD(固态硬盘) U 盘 SD 卡 手机存储 BIOS/UEFI 芯片 可以,加一个 Note,这也是很多教材容易让初学者困惑的地方。
在现代计算机体系结构中,ROM(Read-Only Memory)已经不再表示"绝对不能写"的存储器 ,而是泛指非易失性(Non-Volatile Memory,NVM) ,即断电后仍能保存数据的存储器。
从历史上看,最早的 ROM 在制造完成后内容便固定,用户无法修改,因此称为 Read-Only Memory 。后来出现了 PROM、EPROM、EEPROM ,以及今天广泛使用的 Flash Memory ,它们都能够重新写入数据,只是写入速度较慢、需要特殊的擦除操作(按字节或按块擦除),因此仍然沿用了 ROM 这一名称。
因此,Flash 在广义上属于 ROM(非易失性存储器) ,但它并不是严格意义上的"只读"存储器 ,而是一种可擦除、可重新编程的 ROM 。现代 SSD、U 盘、SD 卡、手机存储以及 BIOS/UEFI 芯片,都是以 Flash 为存储介质。
CD-ROM CD-ROM (Compact Disc Read-Only Memory,只读光盘)是一种光盘存储设备。
数据在生产过程中一次性写入,用户不能修改,只能读取,因此属于典型的只读存储介质。
激光读取头 光盘介质 凹坑/平面编码数据 只读 生产时一次写入 用户不可修改 非易失性 断电数据不丢失 容量约 700 MB 激光读取数据 属于外存 辅助存储器,非半导体 ROM 访问速度远低于半导体存储器 机械旋转 + 光学读取,延迟较高 其特点包括:
非易失性; 容量约 700 MB ; 使用激光读取数据; 访问速度远低于半导体存储器。 需要注意,CD-ROM 属于外存(辅助存储器) ,而前面介绍的 MROM、PROM、EPROM、EEPROM、Flash 都属于 半导体 ROM 。
ROM 属于非易失性存储器,RAM 属于易失性存储器。 ROM 和 RAM 都支持随机存取,不要把 ROM 理解成顺序访问。 Flash Memory 属于 ROM,是现代应用最广泛的非易失性存储器。 EPROM 使用紫外线擦除,EEPROM 使用电擦除,Flash 按块擦除。 3.2 - 多模块存储器 本节的内容会在选择题和解答题中偶尔考察,并且考查方式经常涉及到地址和容量计算,要对多模态存储器的计算流程非常熟悉。
多模块存储器(Multi-module Memory)是指利用多个结构相同的存储模块(或存储芯片)共同构成一个主存系统。
采用多个存储模块主要有两类目的:
提高主存的访问性能 扩大主存容量 虽然这两类技术都使用多个存储模块,但它们的设计目标完全不同:
单体多字存储器 和 多体交叉存储器 的目的是提高主存的带宽和吞吐率 ;位扩展、字扩展和字位扩展 的目的是扩大主存的字长或容量 。多模块存储器 多个结构相同的存储模块 → 主存系统 若干存储模块 按设计目标分为两类 提升访问性能(带宽 / 吞吐率) 扩大一次访问的数据量或并行处理请求 扩大主存容量(字长 / 字数) 连接多个芯片,突破单芯片规格限制 单体多字存储器 一个地址存放 n 个连续字 多体交叉存储器 多个存储体并行 / 交替工作 高位交叉编址(串行) 低位交叉编址(并行) 位扩展 扩展字长(低位编址) 字扩展 扩展字数(高位编址) 字位扩展 同时扩展字长与字数 左侧:不增加容量,靠并行 / 宽数据通路提升访存效率 右侧:不改变访存速度,靠拼接芯片扩大总容量或字长 因此,本节也将分别介绍这两类技术。
单体多字存储器 在介绍单体多字存储器之前,需要先明确一个概念。
通常情况下,一个地址只能对应一个存储字(Word) (这里假设采用 按字编址 )。例如,一个字长为 32 位 的存储器:
地址 数据 地址 数据 地址 数据 地址 数据 0 Word0 1 Word1 2 Word2 3 Word3
CPU 每发出一个地址,只能读出 一个字(32 位) 。
单体多字存储器 则是在一个地址下,同时存放多个连续的存储字。
假设每个字仍然为 m 位 ,但每个地址对应 n 个连续的字 ,则:
地址 数据 0 Word0、Word1、Word2、Word3 1 Word4、Word5、Word6、Word7 2 Word8、Word9、Word10、Word11
例如,当 n=4 时,CPU 发出一次地址访问,就能够一次读出 4 个连续的字 (共 4m 位 )。
CPU 发出一个地址 地址总线 数据总线宽度 = n×m 位 单体多字存储器(每行 n 个字) 地址 存储字(每字 m 位,共 n=4 字) 0 Word0 Word1 Word2 Word3 1 Word4 Word5 Word6 Word7 2 Word8 Word9 Word10 Word11 3 … 一次访问 返回 n 个字 特点 • 每个地址存放 n 个连续存储字(图中 n=4) • 数据总线加宽为 n×m 位,一次取回 n 个字 • 理论带宽提升到原来的 n 倍 • 仅对顺序访问有效;随机/非连续访问无并行收益 普通存储器 一个地址 → 一个字(m 位) 数据总线宽度 = m 位 单体多字存储器 一个地址 → n 个字 数据总线宽度 = n×m 位 带宽 ≈ ×n(仅顺序) 因此:
每个地址对应 n 个连续的字 ; 一个地址访问即可返回 n 个字 ; 数据总线宽度需要扩大为 n×m 位 ; 理论上,存储器带宽可以提高 n 倍 。 这种方式本质上是扩大一次访问的数据宽度 ,而不是让多个存储模块并行处理不同的访问请求。
由于单体多字存储器一次返回的是 固定连续的 n 个字 ,因此它只能提高顺序访问 时的数据传输效率,对于多个独立地址的访问无法提高并行性。
考试中一般只需了解其基本思想即可,真正的重点是 多体交叉存储器 ,它利用多个存储模块并行工作来提高主存的访问带宽。
多体交叉存储器 在 多体交叉存储器 的设计中,为了提高存储系统的并行性和带宽,常采用 交叉编址 的方式将主存划分为多个 存储体(memory bank) 。根据地址在各存储体之间的分布方式,交叉编址又分为 高位交叉编址 和 低位交叉编址 两种。
高位交叉编址 在 高位交叉编址 中,地址的高位 用于选择 存储体 ,低位 表示在该存储体中的偏移地址。
例如:若系统有 4 个存储体,地址空间大小为 4n,则:
地址 0 ~ n−1 存储在 M0 ; 地址 n ~ 2n−1 存储在 M1 ; 地址 2n ~ 3n−1 存储在 M2 ; 地址 3n ~ 4n−1 存储在 M3 。 也就是说,一整个存储体连续存储一段地址空间 ,相邻地址数据往往在同一个存储体中。如下图所示:
由于这种方式下,相邻数据集中在一个存储体中,多个存储体无法并行工作 ,而是 串行工作 :
所有存储体共用一个 地址寄存器(AR) 和 数据寄存器(DR) ; 每次只能访问一个存储体,其它存储体处于空闲状态。 这种串行访问的结构较为简单,适用于对并行性能要求不高的场景,但 无法提升带宽或访问效率 ,无法发挥出多体结构的优势。
高位交叉编址 尽管名称中带有"交叉",但实际上地址在各存储体之间是按连续区间分布的,因此不少教材也称其为 高位连续编址 。
国内《计算机组成原理》教材(如唐朔飞、白中英、王道等)通常都是这样分类:
多体存储器
这里的"交叉"实际上指的是:
多体存储器的一种编址方式
而不是说数据一定是交替存放的。
低位交叉编址 在 低位交叉编址 中,地址的低位 用于选择 存储体 ,高位 用于标识该存储体内的偏移地址。
以 4 个存储体为例,地址 0~3 分别对应 M0、M1、M2、M3 ,地址 4~7 也分别映射到 M0~M3 ,以此类推。这样就实现了 相邻地址分散存储在不同存储体中 的效果:
在这种方式下,多个存储体可以 并行工作 ,大大提高了访问效率。但为了支持并行,每个存储体 都需配备自己的地址寄存器和数据寄存器 ,如下图所示:
M 0 M 1 M 2 M 3 AR AR AR AR DR DR DR DR 地址总线 单字长 数据总线 并行性 在 低位交叉编址 中,相邻地址的数据分布在不同的存储体中 ,因此多个存储体可以交替处理连续的访存请求。这种工作方式与 指令流水线 十分相似,可以显著提高主存的访问带宽。
要理解低位交叉存储器为什么能够实现这种并行访问,首先需要了解 存储周期 的概念。
存储周期
例如,一个存储体的存储周期为 40 ns ,意味着:
第 0 ns 开始访问该存储体; 在接下来的 40 ns 内,该存储体一直处于忙碌状态,不能再次被访问; 只有到 40 ns 后,才能再次访问该存储体。 Memory bank M0 ... t 0 ns 40 ns 忙碌 (Busy) 该存储体正在执行当前访问,无法响应新的请求 可再次访问 完成后重新就绪 第 1 次访问开始 最早可发起第 2 次访问 存储周期 T 从开始一次访问到能再次接受访问所需的最短时间 如果系统只有 一个存储体 ,那么 CPU 连续访问相邻地址时,就必须等待该存储体完成当前访问后才能开始下一次访问,因此连续两次访存之间的最短间隔就是 存储周期 。
而在 低位交叉编址 中,连续地址会被轮流分配到不同的存储体。例如对于四体交叉存储器:
地址 0 → M0 地址 1 → M1 地址 2 → M2 地址 3 → M3 地址 4 → M0 … 这样,当 M0 正在执行一次访存时,CPU 可以立即向 M1 、M2 、M3 发起新的访存请求,而无需等待 M0 完成。当再次轮到访问 M0 时,它通常已经完成了上一轮访问,因此不会发生冲突。
req 0 → M0 req 1 → M1 req 2 → M2 req 3 → M3 M0 M1 M2 M3 M0 忙 (访问地址 0) M0 忙 (访问地址 4) M1 忙 (访问地址 1) M1 忙 (地址 5) ... M2 忙 (访问地址 2) M2 (地址 6) ... M3 忙 (访问地址 3) M3 ... t 0 T/4 2T/4 3T/4 T 5T/4 6T/4 7T/4 2T T / n 存储周期 T n = 4 体低位交叉存储器 • 单体仍需完整周期 T 才能再次接受访问 • 相邻地址被分散到不同存储体,M0~M3 可交错并行 • CPU 每 T/n 就能收到一次数据 → 带宽提升约 n 倍 设主存共有
n T
最小连续访问间隔 = n T
也就是说:
因此,整个主存系统可以平均每 T / n n
这种并行访问之所以能够实现,是因为一次访存过程实际上可以 划分为多个阶段 。为了便于分析,通常将一次读取操作抽象为三个阶段:
P 1 AR )P 2 DR ,该阶段耗时最长,也是存储周期的主要组成部分)P 3 DR 传送给 CPU由于不同存储体相互独立,当一个存储体仍处于 P 2 P 1
假设 CPU 的时钟周期为
t
P 1 t P 2 4 t P 3 t 则对于四体交叉存储器,连续读取八个字的数据时,其流水线执行过程如下图所示:
M 0 M 1 M 2 M 3 M 0 M 1 M 2 M 3 存储体号 时钟周期 1 2 3 4 5 6 7 8 9 10 11 12 P 1 P 2 P 3 P 1 P 2 P 3 P 1 P 2 P 3 P 1 P 2 P 3 P 1 P 2 P 3 P 1 P 2 P 3 P 1 P 2 P 3 P 1 P 2 P 3 13
可以看到,虽然每个存储体仍然需要较长的存储周期才能完成一次访问,但多个存储体的访问过程彼此交错、重叠执行,因此主存能够持续不断地向 CPU 输出数据,从而显著提高整体的吞吐率 。
主存容量的扩展 在设计计算机存储系统时,单个存储芯片的容量和字长往往无法直接满足系统需求。例如,CPU 可能要求主存具有更大的存储容量,或者一次能够读写更宽的数据,而单个存储芯片只能提供有限的 存储字数 和 字长 。因此,需要将多个存储芯片按照一定方式组合起来,构成满足要求的主存,这一过程称为 主存容量的扩展 。
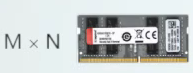
设某存储芯片具有:
则该存储芯片可表示为:
M × N
即共有
M N bi t
根据扩展目标的不同,主存容量扩展主要分为三种方式:
位扩展 :保持存储字数不变,扩展每个存储字的位数(字长)。字扩展 :保持字长不变,扩展存储字数(地址空间)。字位扩展 :同时扩展字长和存储字数。主存扩展和多体交叉存储器有什么关系
多体交叉存储器 和 主存扩展 都需要使用多个存储模块(或存储芯片),因此都会涉及 高位编址 和 低位编址 的地址分配方式。但两者的设计目标完全不同:
多体交叉存储器 :通过将地址分布到多个存储体,提高主存的访问带宽和吞吐率 。主存扩展 :通过连接多个存储芯片,扩大主存的容量或字长 。由于地址映射方式相同,因此主存扩展中也可以借用前面介绍的 高位编址 和 低位编址 来理解:
位扩展 采用 低位编址 。多个存储芯片并行工作,共同组成一个更宽的数据字。字扩展 采用 高位编址 。高位地址用于选择存储芯片,低位地址作为芯片内部地址。字位扩展 同时进行位扩展和字扩展,因此同时采用高位和低位编址。位扩展 位扩展 是指:在 存储字数不变 的前提下,增加每个存储字的 位数 ,也就是扩展存储器的 字长 。
例如,要用若干片
16 K × 8 bi t 16 K × 32 bi t
原芯片:共有
16 K 8 bi t 目标存储器:仍然有
16 K 32 bi t 因此,存储字数没有变化,只是每个存储字从
8 bi t 32 bi t 位扩展 。
16K × 8 WE A CS 16K × 8 WE A CS 16K × 8 WE A CS 16K × 8 WE A CS CPU R/W# A 15-0 D 31-0 D 7 ~D 0 D 15 ~D 8 D 23 ~D 16 D 31 ~D 24 需要的芯片数量为:
16 K × 8 16 K × 32 = 4
也就是说,需要 4 片
16 K × 8 bi t 16 K × 32 bi t
由于是 位扩展 ,所以 4 片芯片在逻辑上对应同一个地址范围。CPU 每访问一个地址,4 片芯片都要同时被选中:
4 片芯片的 片选信号连接在一起 ,并处于常有效状态; 4 片芯片的 地址线连接相同的地址信号 ; 每片芯片提供
32 bi t 8 bi t 因此,一次访问时:
第 1 片芯片提供
D 0 ∼ D 7 第 2 片芯片提供
D 8 ∼ D 15 第 3 片芯片提供
D 16 ∼ D 23 第 4 片芯片提供
D 24 ∼ D 31 这样,4 片芯片并行输出,就能共同组成一个
32 bi t
需要注意的是,如果目标存储器按 字节编址 ,那么
16 K × 32 bi t
16 K × 32 bi t = 16 K × 4 B = 64 K B
所以 CPU 需要
16 A 0 ∼ A 15
但是,每片
16 K × 8 bi t 16 K
log 2 16 K = 14
根地址线。
由于目标存储器每个存储字为
32 bi t = 4 B A 0 , A 1
所以,芯片实际使用的地址线是:
A 2 ∼ A 15
也就是说:
A 2 ∼ A 15 16 K A 0 , A 1 4 片芯片并行工作,共同扩展数据位宽。 需要注意的是,位扩展只是多个芯片共同组成同一个存储字,并不是一次返回多个连续的存储字,因此与单体多字存储器不同。CPU 一次访问仍然只读出一个 Word,只不过这个 Word 的位数变宽了。
字扩展 字扩展 是指:在 每个存储字位数不变 的前提下,增加存储器的 存储字数 ,也就是扩展存储器的地址范围。
例如,要用若干片
16 K × 8 bi t 64 K × 8 bi t
原芯片:共有
16 K 8 bi t 目标存储器:共有
64 K 8 bi t 因此,存储字长没有变化,只是存储字数从
16 K 64 K 字扩展 。
16K × 8 (0) WE A CS 16K × 8 (1) WE A CS 16K × 8 (2) WE A CS 16K × 8 (3) WE A CS CPU R/W# A 15-0 D 7-0 D 7 ~D 0 D 7 ~D 0 D 7 ~D 0 D 7 ~D 0 ramsel 0 ramsel 1 ramsel 2 ramsel 3 MREQ# A 15-14 需要的芯片数量为:
16 K × 8 64 K × 8 = 4
也就是说,需要 4 片
16 K × 8 bi t
目标存储器共有
64 K
log 2 64 K = 16
根地址线,即
A 0 ∼ A 15
每片
16 K × 8 bi t 16 K
log 2 16 K = 14
根地址线。
所以:
低 14 位地址线
A 0 ∼ A 13 高 2 位地址线
A 14 , A 15 由于 4 片芯片分别对应 4 个连续的
16 K
高位地址
A 15 A 14 被选中的芯片 地址范围 00 第 1 片 0 ∼ 16 K − 1 01 第 2 片 16 K ∼ 32 K − 1 10 第 3 片 32 K ∼ 48 K − 1 11 第 4 片 48 K ∼ 64 K − 1
因此,在 字扩展 中:
数据线位数不变,仍然是
8 bi t 地址范围扩大; 同一时刻只有一片芯片被片选信号选中; 高位地址线通常用于产生片选信号。 字位扩展 字位扩展 是指:同时扩展存储器的 存储字数 和 存储字长 。
也就是说,目标存储器相比原存储芯片:
例如,要用若干片
16 K × 8 bi t 32 K × 16 bi t
原芯片:共有
16 K 8 bi t 目标存储器:共有
32 K 16 bi t 因此,这里既要把存储字数从
16 K 32 K 8 bi t 16 bi t 字位扩展 。
16K × 8 (0) WE A CS 16K × 8 (1) WE A CS 16K × 8 (2) WE A CS 16K × 8 (3) WE A CS CPU R/W# A 15-0 D 7 ~D 0 D 7 ~D 0 D 15 ~D 8 D 15 ~D 8 ramsel 0 ramsel 1 MREQ# A 15 D 15-0 需要的芯片数量为:
16 K × 8 32 K × 16 = 4
可以把这 4 片芯片分成两组:
每组 2 片芯片并行工作,用来把字长从
8 bi t 16 bi t 共 2 组芯片,用来把存储字数从
16 K 32 K 也就是说:
4 = 2 × 2
其中:
目标存储器容量为:
32 K × 16 bi t = 32 K × 2 B = 64 K B
如果按 字节编址 ,则 CPU 需要:
log 2 64 K = 16
根地址线,即
A 0 ∼ A 15
每片
16 K × 8 bi t 16 K
由于目标存储器每个存储字为
16 bi t = 2 B A 0
因此,芯片内部地址线使用:
A 1 ∼ A 14
高位地址线
A 15
高位地址
A 15 被选中的芯片组 地址范围 0 第 1 组 前
16 K 1 第 2 组 后
16 K
每组内部的两片芯片并行工作:
一片提供
D 0 ∼ D 7 一片提供
D 8 ∼ D 15 因此,在 字位扩展 中:
通过并联芯片的数据线实现 位扩展 ; 通过高位地址线和片选译码实现 字扩展 ; 同一时刻只选中一个芯片组; 被选中的芯片组内部,多个芯片并行工作,共同组成更宽的数据字。 3.3 - 外存 机械硬盘 偶尔会在大题中考察,在选择题中一般都会有一题,优先掌握 CHS 地址和 性能指标 的计算。
机械硬盘 (Hard Disk Drive, HDD)是一种使用磁性存储介质来存储和读取数据的非易失性存储设备,广泛应用于计算机和数据存储系统中。
存储区域 为了理解机械硬盘是如何存储数据的,需要先了解硬盘的物理结构以及几个基本概念:
盘片(Platter) :盘片是机械硬盘中用于存储数据的圆形磁性介质,通常由铝合金或玻璃制成,表面覆盖有磁性材料。一个机械硬盘通常包含多个盘片,这些盘片固定在同一根主轴(Spindle)上,以相同的速度高速旋转(如 5400 RPM、7200 RPM 或更高)。盘面(Surface) :每个盘片都有 上下两个盘面 ,每个盘面都可以独立存储数据,因此每个盘面都会配备一个对应的 磁头(Head) 。例如,一个拥有 3 个盘片的硬盘共有 6 个盘面 ,因此通常也会配备 6 个磁头 。磁头(Head) :磁头安装在读写臂(Actuator Arm)的末端,用于读取和写入盘面上的数据。所有磁头固定在同一个执行机构上,因此它们会同步移动到相同的半径位置,但只能选择其中一个磁头进行读写。磁道(Track) :磁道是盘面上的一个同心圆环。每个盘面都由许多同心圆组成,每个同心圆就是一条磁道,数据便存储在这些磁道上。柱面(Cylinder) :柱面是所有盘面上 半径相同的磁道 的集合。由于所有磁头始终同步移动,因此当磁头移动到某一个半径时,所有盘面都会同时到达对应的磁道,这些磁道共同构成一个柱面。扇区(Sector) :扇区是磁盘上的最小物理存储单元。每条磁道都会被划分成多个扇区,每个扇区可以存储一定数量的数据,通常为 512 字节 或 4 KB(Advanced Format) 。操作系统和磁盘控制器通常以扇区作为读写数据的基本单位。magnetic layer aluminum plate 1 bit cylinder sector track disk read-and-write heads disk read-and-write head floating on a cushion of air 机械硬盘的数据组织层次可以总结为:
硬盘
└──盘片(Platter)
└──盘面(Surface)
└──磁道(Track)
└──扇区(Sector) ← 最小物理读写单位(512B 或 4KB)
CHS 地址 当磁盘驱动器访问磁盘中的数据时,需要根据 CHS 地址(Cylinder-Head-Sector Address,柱面 - 磁头 - 扇区地址) 定位到目标扇区。柱面号(Cylinder Number) 、磁头号(Head Number) 和 扇区号(Sector Number) 三个字段组成,它们共同唯一标识磁盘上的一个物理扇区:
柱面号(Cylinder Number) :目标扇区所在的柱面
柱面号位数 = ⌈ log 2 (柱面数量) ⌉
磁头号(Head Number) :目标扇区所在的盘面(对应具体磁头)
磁头号位数 = ⌈ log 2 (盘面数量) ⌉
扇区号(Sector Number) :目标扇区在目标磁道上的编号
扇区号位数 = ⌈ log 2 (每条磁道中的扇区数量) ⌉
CHS 地址 Cylinder · Head · Sector 柱面 C 同半径的磁道集合 扇区 S 磁道的最小存储单元 磁头 H H=3 H=2 H=1 H=0 柱面深度 CHS 地址结构 C (10 bits) H (2 b) S (5 bits) 示例:1000 柱面 × 4 盘面 × 32 扇区/磁道,共 17 bits C — 柱面号 目标磁道在哪一组柱面 ⌈log₂(柱面数)⌉ bits H — 磁头号 目标扇区在哪个盘面 ⌈log₂(盘面数)⌉ bits S — 扇区号 目标扇区在磁道中的位置 ⌈log₂(扇区数)⌉ bits 示例定位: C=500 H=2 S=15 → 精确定位到目标扇区 地址总位数 = C位 + H位 + S位 一个磁盘通常由多个盘片组成,每个盘片有两个盘面,每个盘面对应一个磁头。每个盘面划分为多个同心圆磁道,每条磁道又划分为若干个扇区。
访问数据时,磁头首先移动到目标柱面,然后选择对应盘面的磁头,待目标扇区旋转到磁头下方后,即可开始读取或写入数据。
示例 假设一个磁盘有 1000 个柱面、4 个盘面、32 个扇区/磁道:
柱面号位数 :
⌈ log 2 ( 1000 )⌉ ≈ ⌈ 9.97 ⌉ = 10 磁头号位数 :
⌈ log 2 ( 4 )⌉ = 2 扇区号位数 :
⌈ log 2 ( 32 )⌉ = 5 CHS 地址总位数 :
10 + 2 + 5 = 17 因此,一个 CHS 地址需要 17 位 才能唯一表示该磁盘上的任意一个扇区。
例如,C = 500、H = 2、S = 15 表示第 500 个柱面、第 2 个盘面上的第 15 个扇区。磁盘驱动器根据该 CHS 地址即可精确定位到对应的物理扇区。
磁盘性能指标 平均存取时间 平均存取时间 是磁盘完成一次读写操作的平均耗时,由 寻道时间 (Seek Time)、旋转延迟 (Rotational Latency)和 传输时间 (Read/Write Time)这三部分构成:
寻道时间 :磁头从当前位置移动到目标磁道所需的时间,通常与磁头移动距离和致动器性能有关。旋转延迟 :盘片旋转使目标扇区到达磁头下方所需的时间,通常为盘片旋转半圈的平均时间,取决于转速。传输时间 :读取或写入目标扇区数据的实际时间,与扇区大小和数据传输率相关。Rotational latency Sector to access Seek time 平均存取时间的计算公式为 :
平均存取时间 = 寻道时间 + 旋转延迟时间 + 传输时间
数据传输率 数据传输率 表示磁盘每秒向主机传输数据的字节数,反映硬盘的读写速度。假设磁盘转速为
r N D r
D r = r N
数据传输率 Data Transfer Rate D r = r × N 转速(转/秒) × 磁道容量(字节) r 转/秒 N 字节 磁道容量 一圈 = N 字节数据 每秒传输 D_r 字节 r 转速 磁盘每秒旋转的圈数(转/秒) 典型值:5400 rpm ≈ 90 转/秒 7200 rpm ≈ 120 转/秒 N 磁道容量 单条磁道可存储的字节数 = 每磁道扇区数 × 扇区大小 扇区大小通常为 512 B 或 4 KB D r = r × N 数据传输率(字节/秒) 是否每条磁道的扇区数量都一致?
早期 CHS 时代,为了简化控制器设计,每个磁道通常划分为相同数量的扇区。
后来出现了 Zone Bit Recording(ZBR) 技术,由于外圈磁道周长比内圈更长:
外圈磁道可以容纳更多扇区;
内圈磁道容纳较少扇区。
RAID 从 2009 到现在就考过 1 题,而且各种 RAID 的细节太多,建议直接跳过。
RAID 全称为 独立磁盘冗余阵列 (Redundant Arrar of Independent Disks)
RAID 6 Dp C1 B1 A1 Disk 0 Dq Cp B2 A2 Disk 1 D1 Cq Bp A3 Disk 2 D2 C2 Bq Ap Disk 3 D3 C3 B3 Aq Disk 4 Eq E1 E2 E3 Ep RAID 将多个独立的物理磁盘组成一个独立的逻辑盘,数据在多个物理盘上分割交叉存储、并行访问,具有更好的存储性能、可靠性和安全性。
RAID 的实现涉及以下核心技术:
磁盘镜像 :将相同数据写入多块磁盘,提高可靠性。典型如 RAID1 。条带化 :将数据分段交叉存储在多个磁盘上,提升性能。典型如 RAID0 ,但不具备容错能力。奇偶校验 :通过冗余校验位在部分磁盘损坏时重建数据,兼顾可靠性与存储效率。用于 RAID3/5/6 。Cache 机制 :提高读写性能,但本身不增加可靠性,除非使用掉电保护的写缓存。常见 RAID 等级如 RAID1(镜像) 、RAID5(条带化 + 奇偶校验) 、**RAID6(双重奇偶校验)**等在性能与容错能力之间做出不同权衡。
固态硬盘 固态硬盘(Solid State Drive, SSD )是一种使用闪存(NAND Flash )作为存储介质的非易失性存储设备,与传统机械硬盘(HDD )相比,SSD 在性能、耐用性和能效等方面具有显著优势。SSD 具备以下特点:
无机械部件 :SSD 没有旋转盘片、磁头或机械臂等移动部件,它使用闪存存储芯片来存储数据。这意味着它不会受到机械故障的威胁,具有更高的耐用性。更快的读写速度 :SSD 的读写速度远远超过传统的机械硬盘,因为数据可以立即访问,无需等待盘片旋转和磁头寻道。这使得计算机启动更快,应用程序响应更迅速。低访问时间 :由于 没有机械延迟 ,SSD 的访问时间极低,通常在微秒级别。这有助于加快文件读取和数据检索。长寿命 :虽然每个存储单元有写入次数的限制,但现代 SSD 使用错误检查和纠正(ECC)技术,以延长其寿命,并且通常拥有较长的保修期。无碎片化 :SSD 的数据存储方式基于闪存单元,读取速度不受数据物理位置的影响,因此不会像 HDD 那样因数据碎片化而降低性能。局限性 :容量限制 :SSD 的高容量型号(例如 4TB 以上 )价格昂贵,而 HDD 在大容量存储上更具优势。写入寿命有限 :尽管现代技术已大幅延长寿命,但重度写入场景下仍需关注寿命问题。机械和固态硬盘对比 以下是从多个维度对 SSD 和 HDD 进行的详细对比:
HDD 机械硬盘 SSD 固态硬盘 磁性介质 · 机械寻址 闪存介质 · 电子寻址 高速旋转 磁头摆动寻道 盘片 + 磁头 + 机械臂 · 存在旋转与寻道延迟 NAND NAND NAND NAND NAND NAND 主控 Controller 闪存芯片阵列 + 主控 · 纯电子寻址,无机械延迟 顺序读写速度 顺序读写速度 100 ~ 200 MB/s 500 ~ 7000 MB/s 随机访问时间(越短越好) 随机访问时间(越短越好) 5 ~ 10 ms 受寻道 + 旋转延迟制约 < 0.1 ms 电信号直达,微秒级响应 抗震 & 噪音 易受震动 / 摔落损坏 存在旋转 / 寻道噪音 抗震 & 噪音 无机械部件,抗震抗摔 运行完全静音 适用场景 大容量存储 · 冷数据备份 · 成本敏感 适用场景 系统盘 · 高性能计算 · 移动设备 VS 特性 SSD(固态硬盘) HDD(机械硬盘) 存储介质 闪存(NAND Flash) 旋转盘片 + 磁头 机械部件 无,纯电子存储 有,盘片、磁头、机械臂等 读写速度 极快(500 MB/s 至 7000 MB/s,视接口而定) 较慢(100-200 MB/s) 随机访问时间 极低(0.1 毫秒以下) 较高(5-10 毫秒) 耐用性 抗震抗摔,无机械故障风险 易受震动、摔落影响,机械故障风险较高 噪音 无噪音 有盘片旋转和磁头移动的噪音 重量与体积 轻薄,适合移动设备 较重,体积较大 碎片化问题 无需碎片整理 需定期碎片整理以维持性能 适用场景 系统盘、高性能计算、移动设备 大容量存储、备份、成本敏感场景
3.4 - Cache 这个没必要多说了,408 中绝对的重点,每年都必考而且占分值很多,cache 和 虚拟页式存储器 在 计算机组成原理/操作系统 中的地位就是 耶路撒冷 在西方的地位。
一整章都是重点,映射方式、地址结构、写策略等都务必 深入 掌握。
cache 原理 缓存 是一种临时存储数据的硬件或软件组件,旨在加快后续对该数据的访问速度。当您请求数据时,计算机会先检查 缓存 中是否存在该数据。如果存在(称为 “缓存命中” ,Cache Hit),则可以直接从 缓存 中获取数据,而无需访问内存,从而节省时间和资源。如果 缓存 中不存在该数据(称为 “缓存未命中” ,Cache Miss),则需要从内存获取数据,并将其存储在 缓存 中,以备将来使用。
cache 工作原理 缓存 (cache)是计算机系统中的一种用于加速数据访问的技术,其原理是在高速存储介质中暂时存储常用数据,以便更快地满足后续的访问请求。
缓存 对于程序执行的加速主要来自于 计算机程序 的 时间局部性 (Temperal Locality)和 空间局部性 (Spatial Locality):
时间局部性 时间局部性指的就是 “刚刚用过的数据,很可能很快又会被用到 。
这种特性常见于 循环结构和频繁访问的变量 ,例如循环中的计数器或者经常读取的配置值:
int sum = 0 ;
int arr [ 1000 ];
// 初始化数组
// ....
// 访问同一个变量 i 很多次
for ( int i = 0 ; i < 1000 ; i ++ ) {
sum += arr [ i ]; // 访问 arr[i]
sum += arr [ i ]; // 再次访问 arr[i]
}
在 缓存 设计中,利用 时间局部性 意味着一旦数据被加载到 缓存 中,它应该在那里保留一段时间,因为很可能很快会再次需要它。
空间局部性 如果一个数据项被访问,那么存储在其附近的数据项也很可能在不久的将来被访问。
这种特性在数组遍历或结构体访问时尤为明显,因为这些数据元素通常在内存中是连续存储的。
利用 空间局部性 的 缓存 设计会在访问一个数据项时,同时把它附近的数据也加载到 缓存 中,因为这些数据很可能在接下来的操作中被用到。
cache 概念 cache 行 (cache line):cache 行 中包含 各种标记字段 (flag)和 数据 (cache 块)缓存块 (cache 块):cache 中的一块存储空间,是与 主存 进行数据交换的基本单元主存块 :主存 中的一块存储空间,主存块 的大小一般与 cache 块 一致块内偏移 :某一个地址在块内的偏移,找到对应的块后,通过块内偏移找到该地址的具体位置块大小 :用于判断块内偏移的位数,比如
1024 = 2 10 缓存块 Cache block (缓存块),是计算机系统中用于存储的最小数据单元,它是 缓存 中的一个固定大小的数据块。每个 缓存块 包含一定数量的字节或字(通常是 2 的幂次方个字节),并用于存储从 主存 (或更低级别的 缓存 )中加载的数据。
cache block 的目的是为了方便对于 主存 (main memory)数据的 缓存 ,主存块 的大小与 缓存块 大小一致,这样就可以将 缓存块 和 主存块 对应起来。
cache 中的存储空间可以被分为若干个 cache 块 ,主存 也可以被分为若干个 主存块 ,主存 和 cache 间的数据置换是以 块 为基本单位的。页面 为基本单位。
缓存块的大小?
Cache block 的大小在不同计算机体系结构中可以有所不同,通常以字节(bytes)或字(words)为单位来表示。典型的 缓存块 大小可以是 32 字节、64 字节、128 字节等。较大的 缓存块 可以容纳更多的数据,提高了数据的局部性,但在某些情况下,较小的 缓存块 可能更适合,特别是对于小规模的数据访问。
cache 和主存映射方式 Cache 的容量远小于主存,而主存中的任意一个数据块在程序运行过程中,都有可能被调入 Cache。
因此,体系结构必须回答一个核心问题:
当某个主存块需要进入 Cache 时,它可以(或应该)放到 Cache 的哪个位置?
这个从 主存块 → Cache 块 的对应规则,就称为 映射方式(Mapping) 。
从抽象角度看,映射本质上定义了三件事:
可放置性 :允许 放入 Cache 的哪些位置?唯一性或灵活性 :硬件代价与性能权衡 :Cache 映射方式:主存块 → Cache 块的对应规则 主存储器 (容量大,速度慢) 块 0 块 1 块 2 块 3 ⋮ 块 M-2 块 M-1 Cache (容量小,速度快) Cache 块 0 Cache 块 1 Cache 块 2 Cache 块 3 ⋮ Cache 块 N-2 Cache 块 N-1 核心问题:主存块该放到 Cache 的哪里? 1. 可放置性 (Placement) 主存块 X 允许放入 Cache 的哪些位置? 固定一个?多个?任意位置? 2. 灵活性 vs 唯一性 放置越自由 → 命中率越高,硬件越复杂 放置越受限 → 硬件越简单,冲突失效越多 3. 硬件代价与性能权衡 查找复杂度 ↔ 冲突概率 ↔ 命中率 需要在成本、速度、效率之间平衡 三种经典映射方式 直接映射 | 全相联映射 | 组相联映射 映射规则 不同的映射方式,本质上就是在 命中率、访问速度、硬件复杂度 三者之间做不同取舍。
按照“一个主存块能映射到多少个 Cache 块”这一自由度的不同,常见的映射方式可以分为:
直接映射(Direct Mapped) :只能映射到 唯一一个 Cache 块全相联映射(Fully Associative) :可以映射到 任意一个 Cache 块组相联映射(Set Associative) :只能映射到 某一组中的任意一个 Cache 块下面我们从最简单、硬件代价最低 的直接映射开始分析。
直接映射 在 直接映射 (directed mapped)缓存 中,每个 主存块 只能映射到缓存中的 一个特定缓存块 。这意味着每个 主存块只有一个缓存块可以存储它。
主存块号
k
cache 块号 = k mod M
其中:
k M 直接映射例子 假设我们有一个 256KB 的缓存,其中每个缓存块是 64B,对于直接映射的 cache:
缓存 被分为 256KB / 64B = 4096 个 缓存块 。内存 中的数据可以直接映射到这 4096 个位置中的其中一个,比如第 10000 个 主存块 映射到 10000 % 4096 = 1808 个 缓存块 。当一个新的数据块需要被加载时,它会替换掉当前映射到该位置的数据块,不管缓存的其他位置是否为空。 全相联映射 Tag Block 0 1 2 c -1 Block 0 1 2 c -1 2 c 2 m -1 2 c +1 在 全相联缓存 (full associative)中,主存 中的任何块可以映射到缓存中的 任意缓存块 。
其映射关系可表示为:
Cache 行 = 任意行
或更形式化地描述为:
Cache 行号 ∈ { 0 , 1 , 2 , … , C − 1 }
其中
C
由于这种映射关系不是唯一的,而是任意的,所以在根据物理地址去访问 cache 的时候,需要通过 遍历所有 cache 行 来判断是否命中。
如果 cache 的所有行都是满的,新的数据会根据某种 替换策略 cache 块 。
全相联映射例子 假设我们有一个 256KB 的缓存,其中每个缓存块是 64B,对于全相联映射的 cache:
缓存被分为 256KB / 64B = 4096 个 缓存块 。 全相联缓存中的每个主存块可以放置在任何缓存块中,即第 0 到第 4095 个缓存块都可以存储该主存块。 当缓存满时,基于某种 替换策略 替换掉 4096 个 缓存块 中的某一个。 组相联映射 Group 0 Cache Tag Data 0 1 2 c -1 Main Memory Block 0 1 2 c -1 2 c 2 m -1 2 c +1 Group 2 c -1 组相联缓存 (set associative 或 group associative)是 直接映射缓存 和 全相联缓存 之间的一种 折中方案 。它将缓存块分为多个 组 ,每个组包含多个缓存块。主存块可以 映射到组中的任意一个缓存块 。
当我们说一个缓存是 N 路组相连 的,意味着缓存被分为多个 组 ,每个 组 有 N 个 缓存块 (N 路)。这样,当一个内存地址被映射到一个特定的组时,它可以放在该 组的任何一个缓冲块 (一路)上。
如果一个组是满的,新的数据会根据某种 替换策略 缓存块 。
N 路组相联表示一个 组中有 N 个 cache 块 ,而不是 cache 中一共有 N 个组。
组相联映射中,主存块地址到缓存组索引的计算公式为:
组号 = 主存块号 mod 组数
Cache 行 = 组内 N 行中的任意一个
其中:
组相联映射例子 假设我们有一个 256KB 的 缓存 ,其中每个 缓存块 是 64B,我们希望有 4 路组相联的组织。
这意味着 缓存 被分为 256KB / 64B = 4096 个 缓存块 。 因为是 4 路组相联,所以这些块被进一步组织为 4096 / 4 = 1024 个 组 。 每个 组 包含 4 个位置(即 4 路),任何内存地址映射到这个 组 的时候,可以放在这四个位置中的任何一个。 比如第 10000 个 主存块 位于第 10000 % 1024 = 784 个 组 ,可能对应组内的任何一个 缓存块 。 硬件结构 下图展示的是一个 二路组相联 Cache 的结构示意图。
访问时,物理地址中的 组号 (index) 用于定位到 Cache 中的某一 组 。该 组 包含两个 Cache 块 ,每个块有 valid 位 和 tag 字段 。
地址中的 tag 会同时送入两个 比较器 ,分别与组内两个块的 tag 进行匹配,并结合 valid 位 判断是否命中。
如果命中,选择器 (multiplexer)根据比较结果,从两个块中选出正确的数据输出给处理器。若都未命中,则访问 主存 。
🔧 比较器与选择器的作用
比较器 (Comparator):用于判断 Cache 块 中的 tag 是否与当前地址匹配,决定是否命中;选择器 (Multiplexer):在多个块中有可能命中的情况下,负责根据比较结果选出正确的数据路径。在其他映射方式中比较器和选择器的个数是多少 全相联 Cache
没有 index 字段,所有 Cache 行 都可能是目标; 地址的 tag 需要与 每一行 进行比较 ⇒ 需要 一个比较器对应一行 ; 最终由 多输入选择器 从所有行中选出命中的那一行。 ➡️ 优点 :命中率高缺点 :比较器数量多,硬件复杂,延迟高
直接映射 Cache
index 字段直接决定数据应该位于哪一行;只需比较该行的 tag ⇒ 仅需一个比较器 ; 无需选择器,命中即用,否则直接访问 主存 。 ➡️ 优点 :硬件简单,速度快缺点 :容易发生冲突,命中率低
小结表:
映射方式 比较器个数 是否需要选择器 硬件复杂度 命中率 直接映射 1 否 低 低 组相联(n 路) n 是 中 中等 全相联 Cache 行数个 是 高 高
映射方式对比 假设 cache 有 M 个 cache 块 ,对于块号为 k 的 主存块 :
直接映射 :被映射到块号 k % M 的 cache 块 全相连映射 :可能被映射到任意一个 cache 块 组相连映射 :对于 m 路组相连,被映射到组号为 k % (M / m) 的 cache 组 中的任意一个 cache 块 Cache Main Memory Tag Block 0 1 2 c -1 Block 0 1 2 c -1 2 c 2 m -1 2 c +1 Cache Main Memory Tag Block 0 1 2 c -1 Block 0 1 2 c -1 2 c 2 m -1 2 c +1 Group 0 Cache Tag Data 0 1 2 c -1 Main Memory Block 0 1 2 c -1 2 c 2 m -1 2 c +1 Group 2 c -1 直接映射 全相联映射 组相联映射 特点 直接映射缓存 全相联缓存 组相联缓存 主存块到缓存块的映射关系 固定的 任意的 组内任意 硬件复杂度 较低 高 介于两者之间 查找速度 快 相对较慢 介于两者之间 成本 低 高 介于两者之间 性能优点 简单、低成本 无缓存冲突、高性能 较低的缓存冲突,性能适中
关联度 Cache 关联度 (associativity)描述的是一块 主存地址 可以被映射到 缓存 中多少个不同的位置(cache lines)。
根据上面提及的 映射方式对比 可知关联度对比:
全相联 > 组相联 > 直接映射
更高的关联度意味着 缓存冲突 减少,命中率 提高。但是另一方面,硬件开销(比较器、替换策略复杂度)和访问延迟增加。所以关联度选择需权衡性能与成本 。
cache 地址结构 当给定一个 物理地址 时,Cache 的访问过程可以抽象为三个连续的问题:
这个地址属于主存中的哪一个块? 这个主存块在 Cache 中可能出现在哪些位置? 这些位置中是否真的缓存了该主存块? 逻辑划分 因此,从 “硬件判定流程” 的角度,物理地址在逻辑上可划分为以下三部分:
标记 块匹配字段 块内地址
块内地址 作用 :
确定访问数据在一个 主存块 / cache 块 内的具体偏移位数 :
log 2 ( 块大小 ) 说明 :
这一部分 只用于块内寻址 ,与映射方式无关Cache 块匹配字段 作用 :
用于 缩小搜索范围 ,确定该主存块可能被缓存在哪些 cache 块中 含义因映射方式而异 :直接映射
字段含义 :Cache 块号(Cache Block Index)作用 :
一个主存块 只能映射到唯一的一个 cache 块 位数 :
log 2 ( cache 块数 ) 全相联映射
字段含义 :无作用 :
一个主存块 可能被缓存到任意一个 cache 块 位数 :
0 说明 :
必须 并行比较所有 cache 块的 tag 组相联映射
字段含义 :组号(Set Index)作用 :
一个主存块 只能映射到某一组内的若干 cache 块 位数 :
log 2 ( 组数 ) 总结一下三种映射方式的块匹配字段的计算方法:
CacheAddressStructure PhysicalAddress 标记 cache块匹配字段 块内地址 DirectMapping 直接映射 cache块匹配字段 = 块号 位数 = log2(缓存块数量) PhysicalAddress:index->DirectMapping FullyAssociative 全相联映射 cache块匹配字段 = 空 PhysicalAddress:index->FullyAssociative SetAssociative 组相联映射 cache块匹配字段 = 组号 位数 = log2(组数) PhysicalAddress:index->SetAssociative 标记 作用 :
在已确定的候选 cache 块(或某一组)中,
通过比较 tag 判断是否真正命中 位数 :物理地址位数 − Cache 块匹配字段位数 − 块内地址位数
物理地址对应 具体而言,给定一个物理地址,访问 Cache 时的各个字段的对应方式如下图所示:
其中 块内偏移、cache 块号(直接映射)、cache 组号(组相联映射)的位数可以直接根据 cache 的参数计算出来,Tag 字段的位数需要通过物理地址的位数减去其他字段的位数来得到。
cache 存储结构 cache 存储的内容大体上来说可以分为 数据 和 元数据 这两个部分:
数据部分:即 cache 块(cache block),缓存了某个主存块的内容 元数据部分:对 cache 访问的过程进行控制 cache 的存储结构可以理解为一张表:
Cache 存储结构 (标记) (脏位) (访问位) (数据块) 1 0x3A2F 0 0011 主存块副本 (Block 0) 1 0x1B8C 1 0101 主存块副本 (Block 1) 0 - - - (无效数据) ⋮ ⋮ ⋮ ⋮ ⋮ Valid (有效位) : 1位,标识该cache行是否存储有效数据Tag (标记) : 与物理地址的tag字段匹配,判断是否命中Dirty (脏位) : 1位,标记数据是否被修改(回写法需要)Reference (访问位) : 记录访问信息,用于替换算法(如LRU)Block (数据块) : 缓存的主存块副本,实际存储的数据
其中字段的含义与 页表 近似,下面列出了:
有效位 (valid):该 cache 行 是否存储有缓存数据,位数为 1 位。 标记 (tag):根据物理地址中的 tag 字段与该字段匹配,以判断是否命中,位数按照 cache 地址结构 进行计算。 脏位 (dirty):标记该 cache 是否修改过,与 写策略 相关。如果采用 直写法 脏位 。 如果采用 回写法 脏位 。 该字段也常被称为 修改位 。 访问位 (reference):用于记录访问信息,服务于 块替换算法 ,其位数取决于替换算法。 如果采用 LRU 替换算法,则 访问位 的位数为
l o g 2 ( 主存快对应的缓存块数量 ) 数据块 (block):cache 的存储结构依照具体的题目,在某些题目中 脏位 、访问位 不用考虑,如果需要计算 cache 的容量,需要注意这一点。
cache 中的块替换 块替换算法适用于 全相联映射 和 组相联映射 ,因为在这两种组织方式中,同一主存块可能被 多个 cache 块 中的任意一个所缓存;因此当需要把新块写入时必须决定把哪一个已有的 cache 块淘汰。而在 直接映射方式 中,主存块只能对应唯一的 一个 cache 块 ,如果发生冲突,直接用新块覆盖该 cache 块即可,无需额外的替换算法。
Cache 块替换算法的使用场景 直接映射 (Direct Mapping) 主存块: 块 0 块 1 块 2 块 3 ... Cache: Cache 0 Cache 1 ❌ 不需要替换算法 • 每个主存块只能映射到 唯一的一个Cache块 • 例如: 块0、块2 → Cache 0 块1、块3 → Cache 1 • 发生冲突时,直接覆盖 对应的Cache块即可 • 无需选择淘汰哪一个 (因为只有唯一选择) 全相联映射 (Fully Associative) 主存块: 块 0 块 1 块 2 块 3 Cache: Cache 0 Cache 1 Cache 2 ? ✅ 需要替换算法 • 任何主存块可以映射到 任意Cache块 • Cache满时,新块可以 替换任何一个现有块 • 必须使用替换算法决定 淘汰哪个块: - LRU (最近最少使用) - FIFO (先进先出) - Random (随机) 组相联映射 (Set Associative) 主存块: 块 0 块 1 块 2 块 3 Cache组: 组 0 路0 路1 块0,2在此组 组 1 路0 路1 块1,3在此组 ? ✅ 需要替换算法 • 主存块映射到特定组, 但可在组内任意路 • 例如(2路组相联): 块0,2 → 组0的路0或路1 块1,3 → 组1的路0或路1 • 组内满时,需要替换 算法决定淘汰哪一路 • 常用算法: LRU, FIFO等 替换过程 cache 块替换与命中判定过程(以组相联/全相联为例):
确定候选集合
根据地址映射方式,确定对应的 cache 组(组相联)或整个 cache(全相联)作为候选块集合。命中判定
在候选块中:仅对 valid=1 的块进行 tag 比较 ;若存在某块 valid=1 且 tag 匹配,则发生 cache 命中 ,访问结束。 缺失处理(cache miss)
若未发生命中:若候选块中存在 valid=0 的块,则选择其中一个空闲块,将主存块加载到该块中,并设置 valid=1、更新 tag; 若所有候选块均为 valid=1,则根据 块替换算法 (如 LRU、FIFO、随机等)选择一个块进行淘汰,并写入新主存块。 cache_access A CPU 访问物理地址 B 确定候选 cache 块集合 A->B C 是否存在 valid=1 且 tag 匹配的块? B->C D Cache 命中 访问 cache C->D 是 E Cache Miss C->E 否 Z 完成操作 D->Z F 是否存在 valid=0 的空闲块? E->F G 选择一个空闲块 加载主存块 设置 valid=1,更新 tag F->G 是 H 按替换算法选择一块 (LRU / FIFO / Random) F->H 否 G->Z I 淘汰原块 写入新主存块 更新 valid 和 tag H->I I->Z 替换算法 当 CPU 访问某个物理地址而在 cache 中未命中时,需要把该地址所在的 主存块 调入 cache。如果该 主存块 映射到的 cache 块 (即同一路径或同一个集合)已经全部占满,就必须在这些已占用的 cache 块 中挑选一个进行替换。常用的替换策略有 FIFO (先进先出)、LRU (最近最少使用)、LFU (最不经常使用)等。
这套思路与操作系统中的页面置换算法本质相同,详情请参见 页面置换算法
为了实现不同的替换算法,cache 通常需要额外保存一些访问信息(元数据) ,这些信息通常称为 访问位(reference) 或 替换信息 。访问位的位数并不是固定的,而是取决于采用的替换算法。
常见情况如下:
替换算法 每个 cache 行需要保存的信息 位数 Random 无 0 FIFO 通常由整个组维护顺序信息,不需要每个 cache 行保存 0 Clock 访问位(Reference) 1 位 Enhanced Clock Reference + Dirty 1 位访问位 + 1 位脏位 (脏位本来就可能存在,不完全算新增)LRU(教材实现) 最近使用顺序 log 2 ( 组相联度 ) LFU 访问次数计数器 若干位(由实现决定)
例如:
2 路组相联 采用 LRU 时,每个 cache 行需要 1 位访问位 ;4 路组相联 采用 LRU 时,每个 cache 行需要 2 位访问位 ;8 路组相联 采用 LRU 时,每个 cache 行需要 3 位访问位 。在 计算 Cache 容量 时,如果题目要求将 访问位 计算在内,应根据采用的 块替换算法 来确定其位数。
例如:
Clock :每个 cache 行增加 1 位访问位 ;LRU :每个 cache 行增加 log₂(组相联度) 位访问位(教材规定);FIFO 、Random :通常不增加每个 cache 行的访问位。考试中若未特别说明,一般默认 LRU 按教材实现,即每个 cache 行设置 log₂(组相联度) 位访问位。
cache 写策略 因为 cache 实际上存储的是主存的一个小副本,所以对于写操作,就需要考虑两者间的数据一致性的问题。
cache 的写策略代表当我们对某个物理地址上的数据进行写入时,应该如何写入对应的存储单元,以及如何协调 cache 和 主存之间的 数据一致性 ,写策略按照地址查询是否命中 cache 可以分为四种方式。
命中时 如果某次地址查询命中 cache ,可以使用如下策略:
直写法 每次写操作都会同时更新缓存和主存。 这种写策略是 同步的 ,每次更新 缓存 时要同步地更新 主存 。 回写法 当数据被修改时,它首先被缓存在 cache 中,只有当 cache 块被替换时才写入对应的主存块 。 这种写策略是异步的,并不是写入 cache 后立马就要写入主存,可以多次写入 cache 后在另一个时刻再将cache 块写入主存。 如果使用了回写法的话,就需要在 cache 中设置一个脏位。脏位用于记录这个 cache 块是否被写入过,如果被写入过,当这个 cache 块被替换时,
就需要写入到主存中。
可以看到,这种策略将多次 cache 写入合并为一个主存写入,对于写操作比较频繁的场景,其实很大幅度地提升了效率。
未命中时 如果 没有命中 cache ,也有如下策略:
写分配法 物理地址对应主存块被 加载 到 cache 块中(先执行一次对应主存块的读操作),然后更新 cache 块 非写分配法 不加载 主存块至 cache 中,直接更新主存块,只有当执行读操作时才将主存块加载进入 cache 块策略的组合 命中 和 未命中 的方法常常通过如下方式一起使用:
直写法 (write-through)和 非写分配法 (not-write-allocate)通常会一起使用,适用于那些写操作不频繁或者写操作不太可能访问同一数据的情况。回写法 (write-back)和 写分配法 (write-allocate)通常会一起使用,适用于那些写操作频繁的情况。Cache 写策略组合 组合一:倾向主存 直写法 (Write Through) 命中时:同步写 Cache + 主存 + 非写分配法 (Not Write Allocate) 未命中时:直接写主存 特点与适用场景 • 都倾向于操作主存 • 保持数据一致性简单 • 写操作延迟较高 ✓ 写操作不频繁的场景 ✓ 数据局部性较差的场景 组合二:倾向 Cache 回写法 (Write Back) 命中时:仅写 Cache(延迟回写) + 写分配法 (Write Allocate) 未命中时:加载到 Cache 再写 特点与适用场景 • 都倾向于操作 Cache • 减少主存访问次数 • 写操作延迟较低 ✓ 写操作频繁的场景 ✓ 数据局部性较好的场景 💡 记忆要点:直写 + 非分配 → 主存优先 | 回写 + 写分配 → Cache 优先
方法的组合方式很容易被混淆,可以通过如下方式记忆:
直写法 和 非写分配法 都倾向于 主存 操作(写入 主存 )。回写法 和 写分配法 都倾向于 cache 操作(写入 cache )。3.5 - 虚拟存储器 虚拟存储器 和 cache 一样重要,而且考察的方式往往是复合考察,将两者的知识融合在一起放到大题中考察,需要能够从存储系统全局看待这两者的关联。
虚拟存储器 是一种 计算机内存管理技术 ,它在 物理内存 和 磁盘存储 之间创建了一个抽象的、扩展的内存空间,以提供更大的可用内存容量。
设计核心 在于将 逻辑地址空间 与 物理内存 进行 解耦 。程序在 编译和运行 时所看到的是一个连续、完整的虚拟地址空间,而实际上这些地址并不直接对应物理内存中的位置,而是通过 页表和TLB 进行映射。
物理内存 物理内存 (Physical Memory)指的是计算机系统中的实际硬件内存,即随机存取存储器(RAM)。
物理内存 是计算机直接用于存储和操作数据的地方,所有进程的数据和代码实际上都是存储在 物理内存 上。
当访问物理内存时,必须使用 物理地址 ,物理地址就是 物理内存 中每个存储单元的唯一编号
物理内存与虚拟内存架构 虚拟内存空间 进程 1 虚拟地址空间 0x0000 - 代码段 0x1000 - 数据段 0x2000 - 堆 进程 2 虚拟地址空间 0x0000 - 代码段 0x1000 - 数据段 0x2000 - 栈 虚拟地址 (Virtual Address) 连续且独立的地址空间 MMU 地址转换 (页表映射) 物理内存 (RAM) 0x00000 - 进程1代码 0x10000 - 进程2数据 0x20000 - 进程1堆 0x30000 - 进程2代码 0x40000 - 进程1数据 0x50000 - 空闲 0x60000 - 进程2栈 物理地址 (Physical Address) 实际硬件内存位置 💡 每个进程拥有独立的虚拟地址空间,通过 MMU 映射到分散的物理内存位置 虚拟内存 虚拟内存 (Virtual Memory)是一种计算机系统内存管理技术,它使得进程可以认为自己拥有一个 连续且独立的内存空间 ,即使实际上 物理内存 可能不够用或者是分散的。
进程使用 虚拟地址 来访问内存中的数据和指令,而不需要了解 物理内存 的详细情况。进程使用虚拟地址去访问 虚拟内存 ,
当进程访问 虚拟内存 时,操作系统 会将 虚拟地址 转化为物理地址 , 进而根据物理地址去访问 物理内存 。
虚拟内存工作原理 进程 使用虚拟地址 0x0000 - 0xFFFF 认为拥有连续独立 的内存空间 虚拟内存 页面 0 页面 1 页面 2 页面 3 页面 4 ... 连续的虚拟地址空间 操作系统 地址转换 (MMU) 物理内存 帧 5 → 页面1 空闲 帧 2 → 页面0 帧 8 → 页面3 空闲 帧 11 → 页面2 分散的物理地址 访问虚拟地址 转换后的 物理地址 关键概念: • 虚拟地址:连续、独立 • 物理地址:可能分散 页式虚拟存储器 为了更灵活地管理内存,操作系统采用 页式虚拟存储器 的方式,将 虚拟地址空间 和 物理地址空间 都划分为大小固定的 页(Page) 。程序运行时,并不需要将整个虚拟地址空间都加载到 物理内存 中,而是按需将部分 页面 载入内存,其余的页面保存在硬盘上。
页式虚拟存储器 CPU 虚拟地址 地址转换 机构(MMU) 页表查询 TLB缓存 页表 (Page Table) 0 3 在内存 1 X 在磁盘 2 1 在内存 3 X 在磁盘 虚拟地址空间 页面 0 页面 1 (缺页) 页面 2 物理内存 页框 0 (页面0) 页框 1 (页面2) 页框 2 (空闲) 页框 3 (页面0) 页框 4 (空闲) 磁盘存储 页面 1 (交换区) 页面 3 (交换区) 程序映像文件 其他页面... 虚拟地址 页面存在 缺页中断 页面调入 工作流程: ① CPU发出虚拟地址 → ② MMU查询页表 → ③ 若页面在内存则直接访问 ④ 若缺页则触发中断 → ⑤ 操作系统从磁盘调入页面 → ⑥ 更新页表并继续执行 核心优势 • 内存扩展 • 进程隔离 • 按需加载 • 内存共享 当 CPU 发出一条内存访问指令时,地址转换机构 会找到对应的物理页框。如果发现该页面尚未加载到内存,就会触发 缺页中断 。缺页中断交由操作系统内核处理,内核会判断该页面是否在磁盘的交换区或程序映像文件中,如果存在,就将其调入内存。如果内存已满,还需要根据 页面置换算法 (如最近最少使用 LRU 或时钟算法)选择一个合适的页面换出到磁盘,再将新页面调入。整个过程对应用程序是透明的,它只会感知到一次访问延迟,而不会意识到内存与磁盘之间的交换。
这种机制不仅让 有限的物理内存 可以支持 更大规模的虚拟地址空间 ,还实现了多进程之间的 隔离与保护 。每个进程都有自己的页表,彼此之间的虚拟地址不会直接冲突,从而避免了进程间的非法访问。同时,页式虚拟存储器还为实现内存共享提供了可能,比如多个进程可以将不同的虚拟页映射到同一个物理页框,用于共享代码段或数据。
页面划分和地址结构 在 页式虚拟存储器 中,虚拟内存空间 被划分为一个个 虚拟页面 (VP,Virtual Page),物理内存空间 被划分为一个个 物理页面 (PP,Physical Page)。
虚拟地址 (VA, Virutal Address)被划分为 虚拟页面号 (VPN,Virutal Page Number)和 页内偏移 (Offset)这两个字段。
在使用 虚拟地址 去访问 虚拟内存 时,我们可以根据 虚拟页面号 找到该地址所在的 虚拟页面 ,在找到 虚拟页面 后,我们可以根据 页内偏移 找到该地址在 虚拟页面 内的偏移大小。
同理,
物理地址
(PA, Physical Address)被划分为 物理页面号 (PPN,Physical Page Number)和 页内偏移 (Offset)这两个字段。
在使用 物理地址 去访问 物理内存 时,我们可以根据 物理页面号 找到该地址所在的 物理页面 ,在找到 物理页面 后,我们可以根据 页内偏移 找到该地址在 物理页面 内的偏移大小。
需要注意和区分一下以下几个名词,它们具有相同的含义:
虚拟页面 (Virutal Page)= 逻辑页面 (Logical Page)
页框 (Frame) = 物理页面 (Physical Page)
地址翻译机构 CPU 中的 内存管理单元 (Memory Management Unit,MMU)是计算机体系结构的重要组成部分,它负责 虚拟内存 到 物理内存 的地址映射和内存访问的控制。MMU 的主要功能包括:
地址转换 :MMU 负责将程序使用的 虚拟地址 转换为对应的 物理地址 。地址保护 :MMU 实施内存保护策略,以确保不同的程序或进程无法越界访问彼此的内存空间。内存访问权限 :MMU 根据地址映射和保护位(在页表或段表中定义)来控制内存访问权限,包括读、写、执行等。地址翻译是硬件还是软件完成的? 很多同学会困惑:
页表是操作系统维护的,而地址翻译要查页表;但 MMU 又是硬件结构,那地址翻译到底是硬件还是软件完成的?
关键点在于:操作系统“提供规则和数据”,硬件“执行翻译过程”。
首先,页表并不是操作系统可以随意设计的数据结构 。
页表的层级、每一项的位含义(如有效位、权限位、物理页号等),都由 CPU 架构规范(如 x86、ARM)严格定义 。操作系统只是按照该规范,在内存中构造符合格式要求的页表。
其次,真正的地址翻译过程由硬件完成 。
CPU 中的 MMU(Memory Management Unit) 在执行指令时,会自动根据当前页表基址寄存器(如 CR3),按架构规定的流程遍历页表(或通过 TLB 命中),将虚拟地址转换为物理地址。
这个过程对软件是透明的,不需要操作系统逐条参与 。
因此可以总结为:
页表的创建与维护:由操作系统负责(软件) 地址翻译的执行:由 MMU 完成(硬件) 页表 页表 (page table)是操作系统维护的一张表,用于将 虚拟地址 转化为 物理地址 ,每个运行的进程都有自己 页表 。页表 存储在其内存空间中的 内核空间 中,详见进程内存空间 。页表 来执行地址转换。
单级页表 页表 的功能是将 虚拟页号 转换为 物理页号 ,进而实现地址翻译。
对于 单级页表 而言,只需访问一次 页表 即可实现 页面号 的翻译过程。
单级页表结构 一个典型的 单级页表 结构如下图所示: